Een steekproef geeft één getal, zoals het steekproefaandeel p^, om de ware waarde te schatten. Een puntschatting is alleen dat ene getal: een andere aselecte steekproef geeft een ander getal, en het getal zelf zegt niet hoe ver het van de waarheid kan liggen. Een intervalschatting geeft in plaats daarvan een reeks waarden: de schatting met een marge die zegt hoeveel ze kan schommelen.
Voorbeeld
Drie aselecte peilingen onder 100 kiezers over hetzelfde plan geven p^=0,49, 0,56 en 0,61. Ze verschillen tot 0,61−0,49=0,12, en geen enkele is “het” antwoord. Een interval zoals 0,56±0,0973 zegt hoe ver het ware aandeel van 0,56 kan liggen.
Definitie
Het betrouwbaarheidsinterval
Een betrouwbaarheidsinterval is een reeks waarden die uit een aselecte steekproef wordt gemaakt met een methode die de ware waarde bevat bij een vastgesteld deel van alle zulke steekproeven. Dat deel is het betrouwbaarheidsniveau, bijvoorbeeld 95%. Het interval heeft de vorm schatting ± foutmarge: de grenzen zijn p^−E en p^+E, en de foutmargeE is de helft van de breedte van het interval.
Voorbeeld
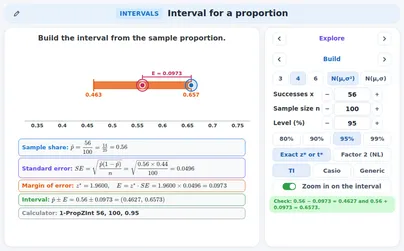
In een aselecte steekproef van 100 kiezers steunen er 56 een plan, dus p^=0,56. Het 95%-interval is (0,4627;0,6573).Het midden is (0,4627+0,6573)/2=0,56, de breedte is 0,6573−0,4627=0,1946 en de foutmarge is E=0,1946/2=0,0973.
Regel
Waar de vorm vandaan komt
Bij een aselecte steekproef is het steekproefaandeel p^ bij benadering normaal verdeeld, met gemiddelde p en standaardafwijking p(1−p)/n (de steekproevenverdeling). In 95% van de aselecte steekproeven ligt p^ binnen 1,96 van die standaardafwijkingen van p. Dan ligt ook p binnen die afstand van p^: het interval rond p^ bevat p. Dat is het hele idee van het interval.
Voorbeeld
Neem p=0,5 en n=100: de standaardafwijking van p^ is 0,5⋅0,5/100=0,05 en 1,96⋅0,05=0,0980.De middelste 95% van de steekproefaandelen ligt dus van 0,5−0,0980=0,402 tot 0,5+0,0980=0,598.
Regel
De standaardfout van het steekproefaandeel
De ware p is niet bekend, dus de standaardafwijking van p^ kan niet worden uitgerekend. De standaardfout zet p^ in de plaats: SE = \sqrt{\dfrac{\hat p (1 - \hat p)}{n}}. Ze schat hoe ver een steekproefaandeel gewoonlijk van p ligt, en wordt kleiner als n groter wordt.
Voorbeeld
Met x=56 en n=100: p^=0,56, 1−p^=0,44.SE=0,56⋅0,44/100=0,2464/100=0,002464≈0,0496.
Regel
De kritieke waarde z*
De kritieke waardez∗ snijdt het middelste oppervlak C van de standaardnormale kromme af, het niveau van het interval, en laat in elke staart (1−C)/2 over. Leer de drie gewone: 90%: z∗≈1,645; 95%: z∗≈1,960; 99%: z∗≈2,576. Voor elk ander niveau gebruik je invNorm op de rekenmachine: het oppervlak links van z∗ is 1−(1−C)/2.
Voorbeeld
Niveau 95%: elke staart heeft (1−0,95)/2=0,025, dus het oppervlak links van z∗ is 1−0,025=0,975.invNorm(0,975; 0; 1)≈1,9600. Op dezelfde manier is z∗≈1,6449 voor 90% (oppervlak links 0,95) en z∗≈2,5758 voor 99% (oppervlak links 0,995).
Tip
De Nederlandse factor 2
De Nederlandse formulekaart schrijft het 95%-interval met de afgeronde factor 2: p^±2p^(1−p^)/n. De factor 2 is iets meer dan 1,96, dus het interval is iets breder. Gebruik hem als een opgave “met de factor 2” zegt, alleen bij niveau 95%; gebruik anders altijd de exacte z∗.
Voorbeeld
Voor 56 van 100: 2⋅0,04964≈0,0993, dus het interval is (0,4607;0,6593).Met 1,96 was het (0,4627;0,6573): de factor 2 is 2% groter dan 1,96 en de foutmarge groeit van 0,0973 naar 0,0993.
Regel
Het interval voor een proportie, stap voor stap
Vier stappen. (1) Het steekproefaandeel p^=x/n. (2) De standaardfout SE=p^(1−p^)/n. (3) De foutmarge E=z∗⋅SE. (4) De grenzen p^−E en p^+E. De rekenmachine doet alle vier tegelijk: 1-PropZInt(x; n; C) op een TI.
Voorbeeld
56 van 100 bij 95%: p^=0,56; SE≈0,0496; E=1,9600⋅0,04964≈0,0973; de grenzen 0,56−0,0973=0,4627 en 0,56+0,0973=0,6573.Rekenmachine: 1-PropZInt(56; 100; 0,95) geeft hetzelfde interval.
Tip
De vier stappen van het AP-antwoord
Een volledig antwoord heeft vier delen. Parameter: zeg in woorden wat p is. Procedure: noem het interval (een z-interval voor één proportie). Voorwaarden: controleer ze met de getallen. Conclusie: het interval, het niveau en een zin in de context volgens het vaste patroon (zie Twee juiste zinnen).
Voorbeeld
Peiling onder 100 kiezers, 56 voor. p = het aandeel van alle kiezers dat het plan steunt. z-interval voor één proportie. Aselecte steekproef; 100 is minder dan 10% van alle kiezers; 56≥10 successen en 44≥10 mislukkingen. Interval (0,4627;0,6573): met een betrouwbaarheid van 95% bevat dit interval het ware aandeel van alle kiezers dat het plan steunt.
Regel
Voorwaarden voor een proportie
Controleer voordat je het interval vertrouwt. Aselect: de steekproef is aselect (of een gerandomiseerd experiment). 10%-voorwaarde: n is hoogstens 10% van de populatiegrootte N, zodat de trekkingen bijna onafhankelijk zijn. Aantallen: het aantal successen np^ en het aantal mislukkingen n(1−p^) zijn allebei minstens 10 (AP; sommige boeken accepteren 5; 9709 vraagt alleen een grote steekproef). Als een voorwaarde niet geldt, is het interval niet gerechtvaardigd.
Voorbeeld
56 van 100: successen 56≥10 en mislukkingen 100−56=44≥10: de aantallen zijn in orde.4 van 30: 4 successen is minder dan 10 (en minder dan 5), de 26 mislukkingen zijn goed: de aantallen voldoen niet, dus het interval (0,0117;0,2550) dat de formule geeft is niet gerechtvaardigd.
Let op!
Het interval is ruw bij kleine aantallen
Dit interval (het Wald-interval) is een benadering: p^ vervangt p in de standaardfout en de normale kromme de exacte aantallen. Bij grote aantallen werkt het goed, maar de echte dekkingsgraad kan onder het niveau liggen, vooral bij kleine aantallen of p dicht bij 0 of 1; als p^ gelijk is aan 0 of 1 is het interval één punt. (Geen examen vraagt het; het staat hier om eerlijk te zijn over “bij benadering”.)
Voorbeeld
Exacte dekkingsgraad van het 95%-interval: voor p=0,5 en n=100 is het 0,9431; voor p=0,1 en n=30 maar 0,8085. In de applicatie bevatten 100 steekproeven met vaste trekking bij p=0,1, n=30 er 81 de waarde 0,1 (een run, niet exact).
Regel
Een hoger niveau geeft een breder interval
Bij dezelfde steekproef heeft een hoger niveau een grotere kritieke waarde z∗ nodig, dus de foutmarge en de breedte nemen toe. Meer betrouwbaarheid in de methode koop je met een minder nauwkeurig interval. Alleen een grotere steekproef geeft allebei: meer betrouwbaarheid en een kleinere foutmarge (zie De foutmarge daalt als 1 / √n).
Voorbeeld
56 van 100 (SE≈0,04964): bij 90% is E=1,6449⋅SE≈0,0816; bij 95% E≈0,0973; bij 99% E=2,5758⋅SE≈0,1279.De intervallen: (0,4784;0,6416), (0,4627;0,6573) en (0,4321;0,6879); het 99%-interval is 1,314 keer zo breed als het 95%-interval.
Regel
Het interval voor een gemiddelde, σ bekend
Als de standaardafwijking σ van de populatie bekend is, heeft het steekproefgemiddelde standaardfout σ/n en is het interval \bar x \pm z^* \cdot \dfrac{\sigma}{\sqrt n}. De foutmarge is E=z∗σ/n. (9709 en de IB AI HL-cursus gebruiken hier de normale verdeling.)
Voorbeeld
Een steekproef van n=36 heeft xˉ=102 en σ=15 is bekend: SE=15/6=2,5.E=1,9600⋅2,5≈4,8999, dus het 95%-interval is (102−4,8999;102+4,8999)=(97,1001;106,8999).
Regel
Een normale populatie of een grote steekproef
Het steekproefgemiddelde is exact normaal verdeeld, met gemiddelde μ en standaardafwijking σ/n, als de populatie normaal is. Voor elke populatie is het bij benadering normaal als n groot is (de centrale limietstelling). Daarom luidt de regel van 9709 “normale populatie of grote steekproef”. Een grotere n maakt het interval ook smaller: σ/n wordt kleiner.
Voorbeeld
Met σ=15: voor n=9 is de standaardfout 15/3=5, voor n=36 is ze 15/6=2,5. Vier keer zo grote steekproef, halve standaardfout, dus halve foutmarge.
Tip
Andere niveaus en de rekenmachine
Elk niveau C kan: z∗ is invNorm(0,975; 0; 1) met 0,975 vervangen door 1−(1−C)/2. De rekenmachine maakt ook het hele interval: ZInterval(15; 102; 36; 0,95) (σ bekend) of TInterval(14,2; 3,1; 12; 0,95) (σ onbekend); op een Casio zijn dat 1-Sample ZInt en 1-Sample tInt. Schrijf de aanroep op die je gebruikte, niet alleen het antwoord.
Voorbeeld
Niveau 98% voor de steekproef xˉ=102, n=36, σ=15: 1−0,02/2=0,99, dus z∗=invNorm(0,99; 0; 1)≈2,3263.E=2,3263⋅2,5≈5,8159 en het interval is (96,1841;107,8159), breder dan dat van 95%.
Let op!
s is niet σ
De standaardafwijking σ van de populatie is bijna nooit bekend. De steekproefstandaardafwijking s is slechts een schatting ervan, en bij een kleine steekproef kan ze er ver naast zitten. s in plaats van σ gebruiken en toch de normale kritieke waarde z∗ nemen is een fout: het negeert de extra onzekerheid die uit s komt. Het antwoord is de t-verdeling (zie De t-verdeling).
Voorbeeld
Twee aselecte steekproeven van 5 uit dezelfde populatie (σ=15): 96;104;100;98;102 heeft s2=10 en s≈3,162; 85;112;100;93;120 heeft s2=199,5 en s≈14,124.De twee waarden van s verschillen een factor 4,5 en geen van beide is gelijk aan 15.
Definitie
De t-verdeling
Als σ onbekend is, standaardiseren we met s: t=(xˉ−μ)/(s/n). Bij een normale populatie volgt dit een t-verdeling met df=n−1vrijheidsgraden. Een t-kromme is symmetrisch en klokvormig als de normale kromme, maar de top is lager en de staarten zijn zwaarder: meer oppervlak ligt ver van het midden. Naarmate df groter wordt, komt de t-kromme dichter bij de standaardnormale kromme.
Voorbeeld
Bij df=5 is het oppervlak voorbij ±2 gelijk aan P(∣T5∣>2)≈0,1019, terwijl het voor de standaardnormale kromme P(∣Z∣>2)≈0,0455 is: de t-kromme heeft meer dan twee keer zoveel in de staarten.
Regel
De kritieke waarde t*
De kritieke waarde t∗ snijdt het middelste oppervlak C van de t-kromme met df=n−1 af. Ze is groter dan z∗ omdat de staarten zwaarder zijn, en ze daalt naar z∗ naarmate df groeit. Bij 95%: t∗=12,706 voor df=1, 2,571 voor df=5, 2,228 voor df=10, 2,042 voor df=30, en 1,960 (de waarde van z∗) voor heel grote df. De rekenmachine geeft haar met invT(0,975; df).
Voorbeeld
Een steekproef van n=12 heeft df=12−1=11, en bij 95% is het oppervlak links 1−0,05/2=0,975: t∗=invT(0,975; 11)≈2,2010, duidelijk meer dan 1,960.
Tip
De gedrukte tabel lezen
De formulekaart van Cambridge drukt t∗ af bij de rechteroverschrijdingskans p. Kies de rij ν=df en de kolom p=1−(1−C)/2: bij 95% is dat de kolom 0,975. De tabel toont drie decimalen (vier cijfers bij grote waarden); de rekenmachine geeft meer cijfers.
Voorbeeld
n=12 bij 95%: rij df=11, kolom p=0,975: 2,201. De rekenmachine geeft 2,2010, dat op drie decimalen hetzelfde afrondt.
Regel
Het interval voor een gemiddelde, σ onbekend
Als σ onbekend is, gebruik je de steekproefstandaardafwijking s en de t-verdeling: \bar x \pm t^* \cdot \dfrac{s}{\sqrt n}, \qquad df = n - 1. De standaardfout is SE=s/n en de foutmarge is E=t∗⋅SE. De IB-gids gebruikt deze regel bij elke steekproefgrootte als σ onbekend is.
Voorbeeld
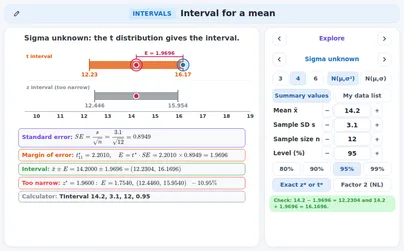
xˉ=14,2, s=3,1, n=12: SE=3,1/12=3,1/3,4641≈0,8949, df=11, t∗=2,2010.E=2,2010⋅0,8949≈1,9696, dus het 95%-interval is (12,2304;16,1696). Rekenmachine: TInterval(14,2; 3,1; 12; 0,95).
Let op!
z in plaats van t geeft een smaller interval
Bij s en een kleine n is de normale kritieke waarde z∗ kleiner dan t∗, dus het interval wordt te smal: het lijkt nauwkeuriger dan het is. Gebruik bij onbekende σ altijd t∗ met df=n−1. Hoe kleiner de steekproef, hoe groter het verschil; bij grote n zijn de twee kritieke waarden bijna gelijk.
Voorbeeld
Voor xˉ=14,2, s=3,1, n=12: met z∗ is de foutmarge 1,9600⋅0,8949≈1,7540, wat (12,4460;15,9540) geeft, tegen E=1,9696 en (12,2304;16,1696) met t∗.Het z-interval is ongeveer 11% smaller dan het hoort te zijn.
Regel
Gepaarde waarnemingen
Bij gepaarde waarnemingen (een voor en een na bij dezelfde route of persoon) trek je binnen elk paar af en behandel je de verschillen als één steekproef: xˉd, sd en n = het aantal paren, df=n−1, en het interval xˉd±t∗sd/n. Zeg in welke volgorde je hebt afgetrokken. Als 0 in het interval ligt, is “geen verschil” aannemelijk.
Voorbeeld
Zes routes, tijden voor 34;29;41;38;27;36 en na 31;28;37;36;26;32 minuten. Voor − na: 3,1,4,2,1,4; xˉd=15/6=2,5, sd2=1,9, sd≈1,3784, SE≈0,5627.df=5, t∗=2,5706, E≈1,4465: het interval (1,0535;3,9465) bevat geen 0.
Regel
Voorwaarden voor een gemiddelde
Controleer drie dingen. Aselect: een aselecte steekproef (of een gerandomiseerd experiment). 10%-voorwaarde: n is hoogstens 10% van de populatie. Vorm: de populatie is normaal, of de steekproef is groot (n≥30 bij AP), of een kleine steekproef heeft gegevens zonder sterke scheefheid en uitschieters. De regels verschillen een beetje: 9709 vraagt een normale populatie of een grote steekproef, de IB-gids neemt een normale populatie aan, AP kijkt naar de grootte en naar de gegevens.
Voorbeeld
Een steekproef van 40 bezorgtijden: 40≥30, dus aan de grootteregel is voldaan (kijk toch naar extreme waarden). Een steekproef van 12 is kleiner dan 30: de gegevens moeten bekeken worden, met een stippendiagram (zie De vorm controleren), voordat het t-interval vertrouwd wordt.
Tip
De vorm controleren: de hekken
Teken bij een kleine steekproef een stippendiagram en zoek naar sterke scheefheid en uitschieters. Een waarde is volgens de 1,5×IQR-regel een uitschieter als ze onder Q1−1,5⋅IQR of boven Q3+1,5⋅IQR ligt (de hekken; de kwartielen zijn de medianen van de onderste en de bovenste helft). Een uitschieter in een kleine steekproef betekent dat het t-interval niet gerechtvaardigd is.
Voorbeeld
Gegevens 12;14;15;15;16;17;18;40 (n=8): Q1=14,5, Q3=17,5, IQR=3, hekken 14,5−1,5⋅3=10 en 17,5+1,5⋅3=22.40>22 is een uitschieter: ze tilt s naar 8,93 (zonder haar is s≈1,98). Gebruik het t-interval niet voor deze gegevens.
Regel
Welk interval?
Vraag wat de gegevens zijn. Een aandeel (successen uit n): het z-interval voor een proportie. Een gemiddelde met bekende σ: het z-interval xˉ±z∗σ/n. Een gemiddelde met onbekende σ: het t-interval met s en df=n−1. Gepaarde waarnemingen: het t-interval voor de verschillen. Controleer dan de voorwaarden van dat interval.
Voorbeeld
“56 van 100 zeggen ja”: een aandeel, dus (0,4627;0,6573). “Gemiddelde 102, σ=15 bekend, n=36”: het z-interval (97,1001;106,8999). “Gemiddelde 14,2, s=3,1, n=12”: het t-interval met df=11, (12,2304;16,1696).
Definitie
Wat “95% betrouwbaar” betekent
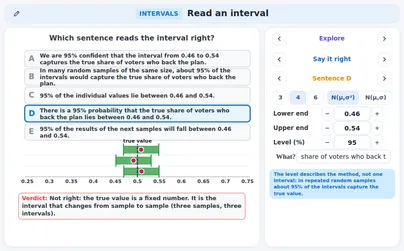
Het niveau beschrijft de methode. Als we veel aselecte steekproeven van dezelfde grootte namen en van elke een interval maakten, zou ongeveer 95% van die intervallen de ware waarde bevatten. Eén interval is raak of mis en we kunnen niet zien welke: de 95% is de dekkingsgraad van de methode op lange termijn. Het interval is het toevallige; de ware waarde is een vast getal.
Voorbeeld
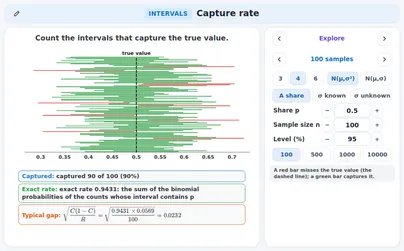
De applicatie trekt 100 steekproeven van 100 met vaste trekking uit p=0,5 en maakt van elke een 95%-interval: 94 ervan bevatten 0,5, 6 missen (andere runs gaven 90 en 95). De exacte dekkingsgraad van deze methode is 0,9431, de som van de binomiale kansen van de aantallen waarvan het interval 0,5 bevat.
Regel
Het interval beweegt, de ware waarde blijft
De ware waarde van de populatie is één vast getal, ook als we haar niet kennen. Elke aselecte steekproef geeft een eigen schatting en dus een eigen interval: het interval verandert van steekproef tot steekproef. Sommige intervallen bevatten de ware waarde en sommige missen haar, en in het echte leven zien we nooit welke.
Voorbeeld
Stel dat het ware aandeel 0,5 is (een peiler weet dat niet). Drie peilingen van 100 geven p^=0,56, 0,46 en 0,63 en de 95%-intervallen (0,4627;0,6573), (0,3623;0,5577) en (0,5354;0,7246). De eerste twee bevatten 0,5; de derde heeft ondergrens 0,5354>0,5 en mist haar.
Regel
Twee juiste zinnen
Twee zinnen zeggen het goed, en in beide is het interval het onderwerp dat bevat. Het patroon van AP en de IB-gids: “Met een betrouwbaarheid van C bevat het interval van a tot b de ware waarde van (de parameter, in de context).” Het patroon van herhaalde steekproeven: “Bij veel aselecte steekproeven van dezelfde grootte bevat ongeveer C van de intervallen de ware waarde van (de parameter, in de context).” Noem de parameter altijd in de context, niet alleen “p”.
Voorbeeld
Voor de peiling met (0,4627;0,6573): “Met een betrouwbaarheid van 95% bevat het interval van 0,4627 tot 0,6573 de ware waarde van het aandeel kiezers dat het plan steunt.” En: “Bij veel aselecte steekproeven van dezelfde grootte bevat ongeveer 95% van de intervallen de ware waarde van het aandeel kiezers dat het plan steunt.”
Let op!
Misvatting 1 (FOUT): de afzonderlijke waarden
FOUT: “95% van de afzonderlijke waarden ligt tussen a en b.” Oordeel: het interval gaat over één getal, de ware waarde van de populatie, niet over de gegevens. Bij een grotere steekproef wordt het interval smaller, terwijl de waarden hun spreiding houden, dus er liggen steeds minder in.
Voorbeeld
Zes metingen 12,1;11,8;12,4;12,0;12,2;11,9: xˉ≈12,0667, s≈0,2160, t∗=2,5706 (df=5), 95%-interval (11,8400;12,2934). Slechts 4 van de 6 metingen liggen erin; 11,8,12,4 liggen erbuiten. Dat is ver onder 95%, en met meer metingen zouden het er minder zijn.
Let op!
Misvatting 2 (FOUT): een kans voor dit interval
FOUT: “Er is een kans van 95% dat de ware waarde van het aandeel tussen a en b ligt.” Oordeel: de ware waarde is een vast getal en zodra de steekproef getrokken is, ligt ook het interval vast: het bevat de ware waarde wel of niet. De 95% hoort bij de methode vóór de steekproef, als het deel van de intervallen dat de ware waarde op lange termijn bevat.
Voorbeeld
Neem de eerste 20 van de 100 intervallen met vaste trekking (p=0,5, n=100): 17 bevatten 0,5 en 3 missen. Elk is raak of mis; geen enkel is “voor 95% raak”. De 95% verschijnt alleen over veel intervallen: 94 van alle 100 bevatten de waarde.
Let op!
Misvatting 3 (FOUT): de volgende steekproeven
FOUT: “95% van de uitkomsten van de volgende steekproeven valt tussen a en b.” Oordeel: het interval is gecentreerd op de uitkomst van deze ene steekproef, niet op de ware waarde, dus latere uitkomsten vallen rond de ware waarde en maar een deel ervan komt in dit interval terecht. Een kans over de volgende steekproefuitkomst is een andere bewering, met een ander getal.
Voorbeeld
Uit 56 van 100 kregen we (0,4627;0,6573). Als het ware aandeel 0,5 is, is het volgende steekproefaantal X van 100 binomiaal met p=0,5, en de volgende p^ valt in dit interval als 47≤X≤65 (want 0,47>0,4627 en 0,65<0,6573).Exact P(47≤X≤65)≈0,7570, ongeveer 76% van de volgende steekproeven, niet 95%.
Let op!
Misvatting 4 (FOUT): de ware waarde beweegt
FOUT: “Het ware gemiddelde verandert van steekproef tot steekproef en komt bij 95% van de steekproeven in het interval terecht.” Oordeel: het ware gemiddelde μ beweegt nooit. Het is de steekproef, en dus het interval, die verandert. Een plaatje van intervallen die rond een vaste lijn springen is het juiste plaatje.
Voorbeeld
Het ware gemiddelde is μ=100 met σ=15 en n=36 (E=4,8999). Steekproeven met xˉ=103, 98 en 106 geven (98,1001;107,8999), (93,1001;102,8999) en (101,1001;110,8999).μ=100 blijft in alle drie op zijn lijn; het derde interval heeft ondergrens 101,1001 en mist hem.
Regel
Waarom het niveau werkt: dezelfde gebeurtenis
De twee uitspraken ∣xˉ−μ∣≤z∗⋅SE en “μ ligt in het interval xˉ±z∗⋅SE” zeggen hetzelfde: xˉ en μ liggen hoogstens z∗⋅SE van elkaar. Omdat xˉ bij een deel C van de aselecte steekproeven binnen z∗⋅SE van μ ligt, bevat een deel C van de intervallen μ. Daar komt het niveau vandaan.
Voorbeeld
μ=100, σ=15, n=36: z∗⋅SE=4,8999. Als xˉ=103: ∣103−100∣=3≤4,8999 en het interval (98,1001;107,8999) bevat 100. Als xˉ=106: 6>4,8999 en het interval (101,1001;110,8999) bevat het niet. De twee uitspraken zijn samen waar of samen onwaar.
Let op!
z met s bevat minder dan het niveau
Maak het 95%-interval met s en z∗=1,96 uit kleine steekproeven en minder dan 95% van de intervallen bevat het ware gemiddelde: de exacte dekkingsgraad is P(∣Tn−1∣<1,96). Het t-interval bevat precies op het niveau. Het tekort is groot bij kleine n en verdwijnt naarmate n groeit.
Voorbeeld
Exacte dekkingsgraden met z∗=1,96: n=5: 0,8784; n=10: 0,9184; n=30: 0,9403. In de applicatie 100 steekproeven van 5 uit N(100;152): z∗ met s bevat er 90, t∗ bevat er 96 (het plaatje toont de eerste 40: 36 en 38).
Let op!
Een interval herstelt een vertekende steekproef niet
De foutmarge meet alleen toevallige variatie. Als de steekproef niet aselect is (vrijwilligers, wie makkelijk te bereiken is) wordt het interval gebouwd rond een vertekende schatting: een grote n maakt het smal en maakt het ten onrechte zekerder. Het niveau geldt alleen voor aselecte steekproeven. Geen formule, niveau of steekproefgrootte herstelt een slechte steekproefmethode.
Voorbeeld
Een website vraagt bezoekers te stemmen en 3100 van 5000 vrijwilligers zeggen ja: p^=0,62, SE≈0,00686, E≈0,0135, het interval (0,6065;0,6335) is heel smal. Als het aandeel van alle kiezers 0,5 is, ligt het interval er ver vandaan: 0,5<0,6065.
Regel
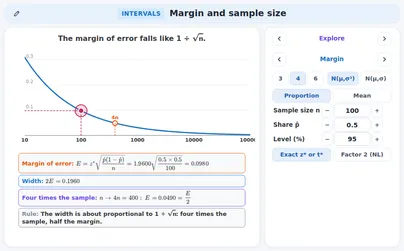
De foutmarge daalt als 1 / √n
De foutmarge E=z∗⋅SE heeft n in de noemer (SE=p^(1−p^)/n of s/n). Vier keer zo grote steekproef geeft dus de halve foutmarge, en honderd keer zo grote steekproef een tiende. Een smaller interval betaal je met veel meer waarnemingen.
Voorbeeld
Met p^=0,5 bij 95%: n=100 geeft E=1,9600⋅0,25/100≈0,0980; n=400 geeft 0,0490; n=1600 geeft 0,0245.Elke stap vermenigvuldigt n met 4 en deelt E door 2.
Regel
De steekproefgrootte voor een proportie
Voor een foutmarge van hoogstens m los je z∗p^(1−p^)/n≤m op naar n: n \ge \left(\dfrac{z^*}{m}\right)^2 \hat p (1 - \hat p). Vul in, reken het getal uit en rond naar boven af op het volgende gehele getal: een kleinere n geeft een foutmarge boven m. Controleer de foutmarge met de gekozen n.
Voorbeeld
Foutmarge m=0,03 bij 95% met p^=0,5: z∗/m=1,9600/0,03≈65,332, in het kwadraat ≈4268,29, keer 0,5⋅0,5=0,25: n≥1067,07, dus n=1068.Controle: n=1067 geeft E≈0,030001>0,03, maar n=1068 geeft E≈0,029987≤0,03.
Tip
De veilige waarde p = 0,5, en de factor 2
Voordat de steekproef genomen is, is p^ niet bekend. Het product p(1−p) is het grootst, 0,25, bij p=0,5, dus p=0,5 is de veilige keuze die nooit een te kleine n geeft; een goede schatting van p geeft een kleinere n. De Nederlandse formulekaart gebruikt de factor 2 voor z∗ (alleen bij 95%): n≥(2/m)2⋅p(1−p).
Voorbeeld
Voor m=0,03 bij 95%: met p=0,5 is n≥1067,07, dus 1068. Als p≈0,2 een goede schatting is, is p(1−p)=0,16 en n≥682,93, dus 683. Met de factor 2 en p=0,5: (2/0,03)2⋅0,25≈1111,11, dus 1112.
Regel
De steekproefgrootte voor een gemiddelde, en naar boven afronden
Voor een gemiddelde met σ bekend (of geschat): z∗σ/n≤m geeft n \ge \left(\dfrac{z^* \sigma}{m}\right)^2. Rond altijd naar boven af, nooit op het dichtstbijzijnde: 216,08 wordt 217, niet 216. Naar beneden afronden breekt de belofte van de foutmarge.
Voorbeeld
σ=15 en foutmarge m=2 bij 95%: z∗σ/m=1,9600⋅15/2≈14,6997, in het kwadraat n≥216,08, dus n=217.Controle: n=216 geeft E≈2,0004>2; n=217 geeft E≈1,9958≤2.
Regel
Afwegingen: niveau, foutmarge en steekproefgrootte
Drie dingen trekken tegen elkaar: het niveau, de foutmarge en de steekproefgrootte. Een hoger niveau of een kleinere foutmarge vraagt een grotere n; de foutmarge halveren vraagt vier keer zoveel n; van 90% naar 99% gaan vraagt ongeveer 2,45 keer zoveel n. Een hoog niveau en een kleine foutmarge uit een kleine steekproef kunnen niet.
Voorbeeld
Steekproefgroottes voor p=0,5: foutmarge 0,05: 271 bij 90%, 385 bij 95%, 664 bij 99%. Foutmarge 0,03: 752, 1068, 1844.Bij 95% vraagt een foutmarge van 0,022401 en een foutmarge van 0,01 vraagt 9604, dat is 4⋅2401. De verhouding van de waarden bij 99% en 90% is (2,5758/1,6449)2≈2,45.
Tip
Een foutmarge uit simulatie
De foutmarge kan ook met simulatie worden gevonden (CCSS S-IC.B.4): neem veel aselecte steekproeven van dezelfde grootte uit een populatie met bekend aandeel p, bereken elk steekproefaandeel en lees de middelste 95% van de waarden af. De helft van de afstand tussen de grenzen is de gesimuleerde foutmarge. Ze komt dicht bij de waarde van de formule, maar niet precies: de simulatie heeft haar eigen toevalsfout.
Voorbeeld
De applicatie trekt 1000 steekproeven van 100 met vaste trekking uit p=0,5: de middelste 95% van de p^-waarden loopt van 0,4100 tot 0,5902, dus de gesimuleerde foutmarge is 0,0901. De formule geeft 1,96⋅0,05=0,0980. Ze liggen dicht bij elkaar; het verschil van 0,0079 komt van de 1000 herhalingen en van p^ dat in stappen van 0,01 beweegt.
Regel
Aannemelijke waarden en beweringen
Om een beweerde waarde te beoordelen kijk je naar het interval. Een waarde binnen het interval is aannemelijk: de gegevens sluiten haar niet uit. Een waarde buiten het interval wordt niet gesteund door de gegevens. Een aannemelijke waarde is niet bewezen: andere waarden in het interval zijn even aannemelijk, dus de gegevens kunnen er niet tussen kiezen.
Voorbeeld
Het interval (0,4627;0,6573) uit 56 van 100. Bewering 0,5: erbinnen (0,4627<0,5<0,6573), aannemelijk, niet uitgesloten. Bewering 0,6: erbinnen, ook aannemelijk: de gegevens kunnen niet kiezen tussen 0,5 en 0,6. Bewering 0,7: 0,7>0,6573, erbuiten, niet gesteund.
Let op!
Overlappende intervallen beslissen geen verschil
Als twee groepsintervallen overlappen kun je niet concluderen dat de groepen niet verschillen. De juiste vergelijking is een interval voor het verschil zelf (een later onderwerp, de intervallen van twee groepen). Het is smaller dan de twee intervallen samen. Als twee intervallen helemaal niet overlappen, verschillen de groepen duidelijk; andersom geldt het niet.
Voorbeeld
Twee groepen van 36 met σ=15: gemiddelden 50 en 58, elk E=4,8999, de intervallen (45,1001;54,8999) en (53,1001;62,8999) overlappen van 53,1001 tot 54,8999. Voor het verschil 58−50=8 is de standaardfout 2⋅2,5≈3,5355, E≈6,9295 en het interval (1,0705;14,9295) bevat geen 0: de groepen verschillen wel.
Tip
Dagelijks leven: een peiling
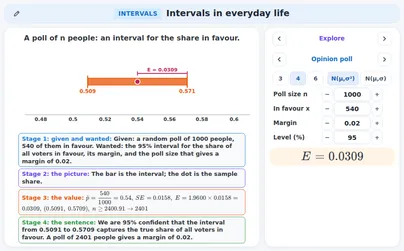
Een peiling meldt een aandeel met een foutmarge, “52%±3,1 procentpunten”. De foutmarge is de E van het interval en haar grootte hangt van n af: ongeveer duizend mensen geven ongeveer drie procentpunten. Een voorsprong kleiner dan de foutmarge is geen duidelijke voorsprong: het interval bevat nog steeds 50%.
Voorbeeld
Een aselecte peiling onder 1000 mensen: 520 voor, p^=0,52, SE≈0,01580, E≈0,0310 (3,1 procentpunten). Het 95%-interval is (0,4890;0,5510): het bevat 0,5, dus “een meerderheid” wordt niet gesteund.Voor een foutmarge van 0,04 is n≥600,23 nodig, dus een peiling onder 601 mensen.
Tip
Dagelijks leven: laboratoriummetingen
Een meting herhalen geeft metingen die een beetje variëren. Hun gemiddelde schat de ware waarde van de grootheid, en het t-interval zegt hoe goed. Meer metingen maken het interval smaller, maar langzaam: de foutmarge daalt als 1/n en t∗ wordt ook kleiner.
Voorbeeld
Zes metingen geven xˉ≈12,0667 en (11,8400;12,2934) met E≈0,2267. Met vier keer zoveel metingen (n=24, df=23, t∗=2,0687) en dezelfde xˉ en s≈0,2160: E≈0,0912, ongeveer 0,40 van de oude foutmarge.
Tip
Dagelijks leven: een fabriekscontrole
Een aselecte steekproef producten wordt gecontroleerd en de defecte worden geteld: een aandeel, dus het interval voor een proportie. Controleer de aantallen: zowel het aantal defecte als het aantal goede producten moet minstens 10 zijn. Een klein aandeel heeft een grote steekproef nodig voor een kleine foutmarge, want het interval is alleen smal als n groot is.
Voorbeeld
12 defecte in 300 producten: p^=0,04, aantallen 12≥10 en 288≥10. SE≈0,01131, E≈0,0222, het 95%-interval (0,0178;0,0622).Voor een foutmarge van slechts 0,01 met p≈0,04: n≥1475,12, dus 1476 producten.
Tip
Dagelijks leven: bezorgtijden voor en na
Tijden op dezelfde routes voor en na een verandering zijn gepaarde waarnemingen. Trek af binnen elke route (voor − na, dus een positief verschil betekent sneller) en maak het t-interval van de verschillen. Als 0 buiten het interval ligt, wordt de verandering gesteund; als het erbinnen ligt, is “geen verandering” aannemelijk.
Voorbeeld
Acht routes, verschillen 3,1,5,1,4,−1,3,5 minuten: som 21, xˉd=2,625, sd≈2,1339, SE≈0,7545, df=7, t∗=2,3646, E≈1,7840.Het 95%-interval is (0,8410;4,4090): het bevat geen 0, dus de tijden zijn echt gedaald.
Tip
Welke cursus vraagt wat
Cambridge 9709 (Paper 6): het interval voor een gemiddelde en een benaderend interval voor een proportie; de formulekaart MF19 drukt de kritieke waarden af. IB AI HL (AHL 4,16): normaal als σ bekend is, t zo niet; de IB AA-cursus heeft geen betrouwbaarheidsintervallen (niet geëxamineerd bij IB AA). AP Statistics (eenheden 3 en 4): voorwaarden, interpretatie, beweringen, steekproefgrootte. CCSS S-IC.B.4: een foutmarge uit simulatie. Nederlandse wiskunde A: de uitspraak met zijn betrouwbaarheid, de formulekaart met de factor 2. Geen Britse A level-, GCSE- of IGCSE-cursus vraagt een betrouwbaarheidsinterval.
Voorbeeld
9709: het z-interval voor een gemiddelde en het interval voor een aandeel. IB AI HL: ook het t-interval en de rekenmachine. AP: de vier stappen van het antwoord. Nederlands: de factor 2 en een steekproefgrootte (1112 bij een foutmarge van 0,03).
Oefenen
Een aselecte peiling onder 200 mensen vindt 110 voorstanders van een plan. Bereken het steekproefaandeel p^ en de standaardfout SE. Makkelijk
Toon de oplossing
Het steekproefaandeel is p^=110/200=0,55.
Dan is p^(1−p^)=0,55⋅0,45=0,2475 en gedeeld door n: 0,2475/200=0,0012375.
SE=0,0012375≈0,0352.
p^=0,55 en SE≈0,0352
Controle → 0,0352⋅0,0352≈0,00124, dat is 0,0012375 afgerond.
Geef voor de peiling onder 200 mensen met 110 voorstanders het 95%-betrouwbaarheidsinterval voor het aandeel voorstanders onder alle kiezers (4 decimalen). Makkelijk
Toon de oplossing
SE≈0,0352 en z∗=1,9600 voor 95%.
De foutmarge is E=1,9600⋅SE≈0,0689.
De grenzen zijn 0,55−0,0689=0,4811 en 0,55+0,0689=0,6189.
(0,4811;0,6189)
Controle → bij 90% is de foutmarge kleiner (0,0579), bij 99% groter (0,0906): de waarde bij 95% ligt ertussen.
Welk interval? (a) 38 van 120 bussen waren te laat. (b) Het gemiddelde van 50 metingen, met bekende σ=2,4. (c) Het gemiddelde van de tijden van 15 leerlingen, met s uit de steekproef. Noem het interval en de vrijheidsgraden als die er zijn. Makkelijk
Toon de oplossing
(a) is een aandeel: het z-interval voor een proportie.
(b) is een gemiddelde met bekende σ: het z-interval xˉ±z∗σ/n.
(c) is een gemiddelde met onbekende σ: het t-interval met df=15−1=14.
(a) z-interval voor een proportie; (b) z-interval voor een gemiddelde; (c) t-interval, df=14
Controle → alleen (c) gebruikt s uit een steekproef, dus alleen (c) heeft t∗ nodig.
Een 95%-interval voor een aandeel is (0,42;0,58). Bepaal het steekproefaandeel en de foutmarge. Makkelijk
Toon de oplossing
Het steekproefaandeel is het midden: (0,42+0,58)/2=0,5.
De breedte is 0,58−0,42=0,16.
De foutmarge is de helft van de breedte: 0,16/2=0,08.
p^=0,5 en E=0,08
Controle → 0,5−0,08=0,42 en 0,5+0,08=0,58.
Zoek de kritieke waarde t∗ in de gedrukte tabel: (a) een 95%-interval uit een steekproef van 8; (b) een 99%-interval uit een steekproef van 20. Makkelijk
Toon de oplossing
(a) df=8−1=7; bij 95% is de kolom p=1−0,05/2=0,975: t∗=2,365.
(b) df=20−1=19; bij 99% is de kolom p=1−0,01/2=0,995: t∗=2,861.
(a) 2,365; (b) 2,861
Controle → beide zijn groter dan de bijbehorende z∗ (1,960 en 2,576), zoals het hoort bij een kleine df.
Een 95%-interval voor een gemiddelde is (97,1;106,9). Bepaal het steekproefgemiddelde en de foutmarge. Is de waarde 100 aannemelijk? En 110? Makkelijk
Toon de oplossing
Het steekproefgemiddelde is het midden: (97,1+106,9)/2=102.
De foutmarge is de helft van de breedte: (106,9−97,1)/2=4,9.
100 ligt erbinnen (97,1<100<106,9): aannemelijk. 110>106,9 ligt erbuiten: niet gesteund.
xˉ=102, E=4,9; 100 is aannemelijk, 110 wordt niet gesteund
Controle → 102−4,9=97,1 en 102+4,9=106,9. Dat 100 aannemelijk is bewijst niet dat μ=100.
Een aselecte steekproef van 25 heeft gemiddelde 48 en de standaardafwijking van de populatie is bekend: 6. Bepaal het 95%-interval voor het gemiddelde (4 decimalen). Middel
Toon de oplossing
SE=σ/n=6/5=1,2.
E=1,9600⋅1,2≈2,3520.
Het interval is 48−2,3520=45,6480 tot 48+2,3520=50,3520.
Dezelfde steekproef (gemiddelde 48, n=25) heeft steekproefstandaardafwijking s=6, en σ is niet bekend. Bepaal het 95%-interval en vergelijk de foutmarge met de vorige. Middel
Toon de oplossing
df=25−1=24 en t∗=2,0639 bij 95%.
SE=s/n=6/5=1,2 en E=2,0639⋅1,2≈2,4767.
Het interval is (45,5233;50,4767); de foutmarge is 2,4767−2,3520=0,1247 groter dan met z∗.
(45,5233;50,4767); de foutmarge 2,4767 is iets groter dan 2,3520
Controle → t∗=2,0639>1,9600=z∗ voor df=24.
In een aselecte steekproef van 40 leerlingen lopen er 6 naar school. Mag het 95%-interval voor een proportie worden gebruikt? Zeg wat je concludeert. Middel
Toon de oplossing
De aantallen: successen 6 en mislukkingen 40−6=34. AP vraagt allebei minstens 10: 6<10 voldoet niet.
De formule zou geven p^=0,15, SE≈0,0565, E≈0,1107 en het interval (0,0393;0,2607).
Volgens de regel van AP voldoen de aantallen niet, dus het interval is niet gerechtvaardigd
Nee: slechts 6 successen (minder dan 10), dus het interval (0,0393;0,2607) is niet gerechtvaardigd
Controle → 6+34=40, en 6/40=0,15.
Voor een aandeel is bij 95% een foutmarge van hoogstens 0,05 gewenst, en over p is niets bekend. Hoe groot moet de steekproef zijn? Middel
Toon de oplossing
Als niets bekend is, neem je de veilige waarde p=0,5: p(1−p)=0,25.
n≥(z∗/m)2⋅0,25=(1,9600/0,05)2⋅0,25≈384,15.
Rond naar boven af: n=385.
n=385
Controle → 384,15 is geen geheel getal en de steekproefgrootte moet minstens zo groot zijn: naar boven afronden, nooit naar beneden.
Een 95%-interval voor het aandeel leerlingen dat naar school loopt is (0,31;0,45). Schrijf de conclusie volgens het vaste patroon, in de context. Middel
Toon de oplossing
Noem de parameter in woorden: het aandeel van alle leerlingen dat naar school loopt.
Het interval is het onderwerp dat bevat: “het interval van 0,31 tot 0,45 bevat de ware waarde”.
Voeg het niveau toe als “Met een betrouwbaarheid van 95% …” en de context.
Met een betrouwbaarheid van 95% bevat het interval van 0,31 tot 0,45 de ware waarde van het aandeel van alle leerlingen dat naar school loopt.
Controle → het midden is (0,31+0,45)/2=0,38 en de foutmarge (0,45−0,31)/2=0,07; de zin gaat over het interval, niet over de leerlingen.
Vijf leerlingen maken een toets voor en na een les; de verschillen (na − voor) zijn 4;7;−1;5;5. Bepaal het 95%-interval voor het gemiddelde verschil. Is 0 aannemelijk? Middel
Een leerling schrijft bij het interval (0,31;0,45) over het aandeel leerlingen dat naar school loopt: “Er is een kans van 95% dat de ware waarde van het aandeel tussen 0,31 en 0,45 ligt.” Dit is FOUT. Leg uit waarom en schrijf een juiste zin. Moeilijk
Toon de oplossing
De ware waarde is één vast getal; het getrokken interval ligt ook vast, dus het bevat haar wel of niet.
De 95% hoort bij de methode: bij veel aselecte steekproeven bevat ongeveer 95% van de intervallen de waarde.
Een juiste zin: “Met een betrouwbaarheid van 95% bevat het interval van 0,31 tot 0,45 de ware waarde van het aandeel van alle leerlingen dat naar school loopt.”
Het interval is het toevallige en de ware waarde ligt vast; de 95% beschrijft de methode. Juiste zin: zie de laatste stap
Controle → in de juiste zin is het interval het onderwerp dat bevat.
De standaardafwijking van een populatie is 15. Hoe groot moet de steekproef zijn voor een foutmarge van hoogstens 2 bij 99%? Vergelijk met de steekproefgrootte bij 95%. Moeilijk
Toon de oplossing
Bij 99%: z∗=2,5758.
n≥(z∗σ/m)2=(2,5758⋅15/2)2≈373,21.
Rond naar boven af: n=374, tegen 217 bij 95% (uit 216,08).
n=374 bij 99%, tegen 217 bij 95%
Controle → de verhouding (2,5758/1,9600)2≈1,73 en 216,08⋅1,73≈374, dicht bij 374.
De peiling onder 1000 mensen met 520 voorstanders wordt met de Nederlandse factor 2 uitgewerkt. Bepaal het interval en vergelijk het met het interval met z∗=1,96. Moeilijk
Toon de oplossing
p^=0,52 en SE≈0,01580.
Met de factor 2: E=2⋅0,01580≈0,0316, het interval (0,4884;0,5516).
Met z∗: E≈0,0310 en (0,4890;0,5510); het interval met factor 2 is iets breder.
Factor 2: (0,4884;0,5516); met z∗: (0,4890;0,5510)
Controle → 2>1,96, dus de foutmarge met de factor 2 (0,0316) is groter dan 0,0310; beide intervallen bevatten 0,5.
Een steekproef van 5 heeft xˉ=20 en s=4. Bepaal het 95%-interval met t∗ en het interval dat een leerling krijgt met z∗=1,96. Hoeveel breder is het juiste interval (in %)? Moeilijk
Toon de oplossing
SE=4/5≈1,7889; df=4, t∗=2,7764, E≈4,9667: het interval is (15,0333;24,9667).
Met z∗: E≈3,5061 en (16,4939;23,5061).
De foutmarges verhouden zich als 2,7764/1,96≈1,417: het juiste interval is ongeveer 41,7% breder.
ongeveer 41,7% breder: (15,0333;24,9667) tegen (16,4939;23,5061)
Controle → het z-interval met s bevat het ware gemiddelde bij maar ongeveer 87,8% van zulke steekproeven.
Een peiling onder 400 mensen heeft foutmarge 0,049 bij 95% (met p=0,5). De peiler wil de helft van die foutmarge en niveau 99%. Hoeveel mensen zijn er nodig, en hoeveel keer zoveel als de oude n? Moeilijk
Toon de oplossing
De nieuwe foutmarge is 0,049/2=0,0245 en z∗=2,5758.
n≥(2,5758/0,0245)2⋅0,25≈2763,39, dus n=2764.
Vergeleken met 400: 2764/400≈6,91 keer; alleen de foutmarge halveren geeft 4 keer (tot 1600 bij 95%), en niveau 99% voegt de rest toe.
n=2764, ongeveer 6,91 keer de oude steekproef
Controle → 4⋅1,73≈6,9, waarbij 1,73≈(2,5758/1,9600)2.
Twee groepen van 36 hebben gemiddelden 50 en 58 en in beide is σ=15 bekend. Hun 95%-intervallen overlappen. Laat dat zien dat de groepen niet verschillen? Gebruik het interval voor het verschil 58−50 met standaardfout 2⋅15/6 (een later onderwerp). Moeilijk
Toon de oplossing
Elke groep heeft E=4,8999: (45,1001;54,8999) en (53,1001;62,8999) overlappen.
Voor het verschil 8: SE=2⋅2,5≈3,5355 en E=1,9600⋅3,5355≈6,9295.
Het interval (1,0705;14,9295) bevat geen 0, dus de groepen verschillen wel, hoewel de groepsintervallen overlappen.
Nee: het verschilinterval (1,0705;14,9295) sluit 0 uit, dus overlap beslist het niet
Controle → 1,0705>0. (Het punt: overlappende groepsintervallen beslissen het niet.)
Een kleine steekproef heeft de waarden 3;5;6;6;7;8;9;25. Is een t-interval gerechtvaardigd? Gebruik de hekken van de 1,5×IQR-regel. Moeilijk