Interactive Lessons

Statistiek met de computer: grote datasets

Lesnotities

Definitie

Een grote dataset sorteren en filteren

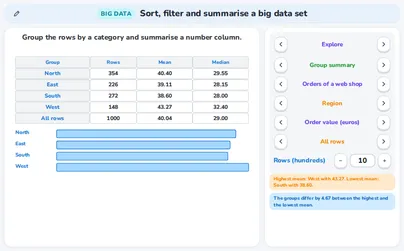
Een grote dataset is een tabel met honderden of duizenden rijen: één rij voor elk geval en één kolom voor elke eigenschap. Je kunt hem niet rij voor rij lezen, dus laat je de computer helpen. Bij sorteren komen de rijen in de volgorde van één kolom, kleinste of grootste eerst; rijen met dezelfde waarde blijven in hun oorspronkelijke volgorde. Een filter houdt alleen de rijen over die aan een regel voldoen. Zeg na een filter altijd hoeveel rijen er van alle rijen overblijven. Bij Sorteren en filteren kies je de kolom, de richting en het filter en zie je de eerste rijen, de aantallen en een samenvatting van de kolom.
Voorbeeld
De bestellingen van een webshop: 1 000 rijen. Gesorteerd op levertijd, grootste eerst, is de eerste rij bestelling 40 met 99 dagen (rood: onmogelijk). Het filter Regio is Noord houdt 354 van de 1 000 rijen over en haalt 646 rijen weg → . Als percentage → , dus er blijft 35,4% van de rijen over.
#ValueItemsDelivery ▼Region4051.5399West33218.2199North51110.3199East654133699East75534.2299North
Let op!

Onmogelijke waarden

In echte data kunnen sommige waarden niet kloppen: een levertijd van 99 dagen, een rit van 0 minuten, 24 uur schermtijd op één dag. Zulke onmogelijke waarden zijn vaak een foutcode of een slordigheid. Zoek ze op voordat je gaat rekenen: sorteer de kolom en kijk naar beide uiteinden. Ze trekken het gemiddelde mee en rekken een histogram uit. Laat ze weg met het filter Alleen aannemelijke rijen en bereken het gemiddelde opnieuw. De mediaan beweegt nauwelijks, want die kijkt alleen naar het midden.
Voorbeeld
Levertijd: 7 van de 1 000 rijen zeggen 99 dagen. Met die rijen is het gemiddelde 4,786 dagen, dus het totaal is . Zonder die rijen → en er blijven rijen over, dus het gemiddelde is dagen. De mediaan blijft 4.
Definitie

Het groepsoverzicht

Een groepsoverzicht neemt één kolom met categorieën (de rijder) en één kolom met getallen (de rittijd) en geeft voor elke groep het aantal rijen, het gemiddelde en de mediaan; de laatste rij is voor alle rijen. Vergelijk de gemiddelden van de groepen en kijk ook naar de medianen: een gemiddelde ver boven de mediaan wijst op een paar heel grote waarden. Bij Groepsoverzicht kies je de categorie, de kolom met getallen en of onmogelijke rijen meetellen.
Voorbeeld
Ritten met deelfietsen (988 aannemelijke ritten): leden 572 ritten, gemiddelde 12,08, mediaan 10 minuten; bezoekers 416 ritten, gemiddelde 10,39, mediaan 9. De leden rijden gemiddeld minuten langer. Het gemiddelde van alle ritten is een gewogen gemiddelde → en .
GroupRowsMeanMedianmember57212.0810visitor41610.399all rows98811.3710
Regel

De kruistabel: aantallen en percentages

Een kruistabel telt de rijen voor elk paar van twee categorieën: de ene categorie geeft de rijen, de andere de kolommen en de totalen staan aan de randen. Een percentage van elke rij zegt hoe elke rij verdeeld is; gebruik het om rijen met elkaar te vergelijken. Een percentage van elke kolom zegt hoe elke kolom verdeeld is. Zeg altijd van welk totaal je het percentage neemt. Bij Twee categorieën wissel je tussen aantallen en beide soorten percentages.
Voorbeeld
Regio en soort klant (1 000 bestellingen). De rij West heeft 84 nieuwe en 64 terugkerende klanten → . Als percentage van de rij → , dus 56,8% van de bestellingen uit West komt van nieuwe klanten. Als percentage van de kolom → , dus 14,5% van alle nieuwe klanten zit in West.
RegionnewreturningTotalNorth204150354East13987226South151121272West8464148Total5784221000
Regel

Het histogram: klassenbreedte en vorm

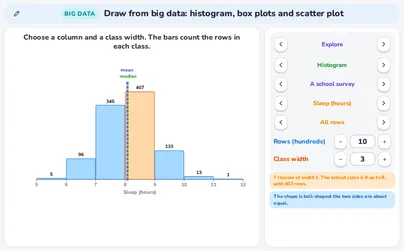
Een histogram telt de rijen in klassen met dezelfde breedte. De hoogte van een staaf is een aantal rijen, geen waarde. Een waarde op de grens van twee klassen valt in de klasse rechts ervan. De klassenbreedte doet ertoe: te smal en het plaatje is rommelig, te breed en de vorm verdwijnt. Lees de vorm: klokvormig, rechtsscheef of linksscheef (een lange staart aan die kant) of twee toppen (twee groepen). Het gemiddelde wordt naar de lange staart getrokken, dus bij een rechtsscheve vorm ligt het gemiddelde boven de mediaan. Bij Histogram kies je de kolom en de klassenbreedte.
Voorbeeld
Levertijd zonder de onmogelijke rijen (993 rijen), klassen van 1 dag breed. De hoogste klasse is 3 tot 4 met 260 rijen. De staart loopt naar rechts, tot 14 dagen: de vorm is rechtsscheef en het gemiddelde 4,12 ligt boven de mediaan 4.
12226025819597331573212468101214medianmeanDelivery time (days)
Regel

Boxplots en uitschieters

Een boxplot laat vijf getallen van een kolom zien: de kleinste waarde, het eerste kwartiel Q₁, de mediaan, het derde kwartiel Q₃ en de grootste waarde. De box bevat de middelste helft van de rijen en zijn lengte is de interkwartielafstand IQR = Q₃ − Q₁. Een waarde is een uitschieter als hij meer dan 1,5 × IQR buiten de box ligt: boven Q₃ + 1,5 × IQR of onder Q₁ − 1,5 × IQR. De snor stopt bij de laatste waarde binnen die grenzen. Met één box voor elke groep vergelijk je de medianen, de spreiding en de uitschieters. Bij Boxplots kies je een kolom en alle rijen of groepen.
Voorbeeld
Rittijd van de bezoekers (416 ritten): Q₁ = 6, mediaan 9, Q₃ = 13, dus IQR = . De bovengrens is minuten: de snor eindigt bij 23 en 14 ritten zijn uitschieters. Bij de leden is Q₁ = 7, Q₃ = 15, IQR = 8 en de bovengrens .
membervisitor01020304050607080Trip time (minutes)
Regel

Het spreidingsdiagram, r en de lijn

Een spreidingsdiagram zet twee kolommen met getallen tegen elkaar uit: één punt voor elke rij. Bij duizenden rijen tekent de applicatie hooguit 500 punten; de getallen gebruiken alle rijen. De correlatiecoëfficiënt r ligt tussen −1 en 1: het teken is de richting en de grootte is de sterkte (onder 0,2 nauwelijks verband, 0,2 tot 0,5 zwak, 0,5 tot 0,8 matig, 0,8 en meer sterk). De regressielijn y = ax + b laat de trend zien, geen regel voor elke rij. Een verband in de data laat niet zien dat de ene kolom de andere veroorzaakt. Bij Spreidingsdiagram kies je de twee kolommen.
Voorbeeld
Ritten: de afstand tegen de gebruikte accu. Voor de 40 ritten van het plaatje is r = 0,90 (voor alle 988 ritten r = 0,96), een sterk verband, stijgend, en de lijn is .86x + 0,94. Bij geeft de lijn procent.
0123456705101520r = 0.90Distance (km)Battery used (%)
Definitie

Steekproeven: aselect en vertekend

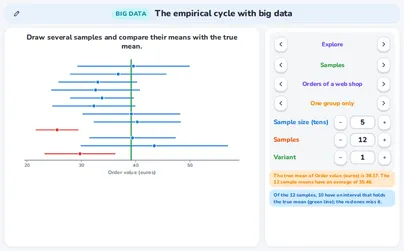
Een steekproef is een deel van de rijen. In een aselecte steekproef heeft elke rij dezelfde kans om gekozen te worden, dus de steekproefgemiddelden komen aan beide kanten van het werkelijke gemiddelde terecht. Een steekproef van één groep alleen, of van vrijwilligers (rijen met grote waarden doen sneller mee), is vertekend: de gemiddelden liggen aan één kant van het werkelijke gemiddelde. Een grotere steekproef geeft een kleinere marge, maar herstelt de vertekening niet. Bij Steekproeven trek je meerdere steekproeven en zie je hun gemiddelden als stippen met het werkelijke gemiddelde als groene lijn.
Voorbeeld
Elektriciteitsgebruik van 1 970 huishoudens: het werkelijke gemiddelde is 208,2 kWh per maand. Acht aselecte steekproeven van 40 rijen: 4 gemiddelden liggen eronder en 4 erboven (de blauwe stippen). Acht steekproeven van vrijwilligers: alle 8 gemiddelden liggen erboven, van 222,6 tot 262,0 (de oranje stippen): de steekproef is vertekend.
200225250275300Electricity (kWh a month)
Regel

De marge van een steekproefgemiddelde

Het gemiddelde van een steekproef is niet precies het gemiddelde van alle rijen. De marge zegt hoever het ernaast kan zitten: marge = , met de standaardafwijking van de steekproef en het aantal rijen. Het interval gemiddelde ± marge bevat dan het werkelijke gemiddelde bij ongeveer 95 van de 100 aselecte steekproeven. Een grotere n geeft een kleinere marge: voor een marge die half zo groot is heb je vier keer zoveel rijen nodig. Twee groepen verschillen zeker alleen als hun intervallen elkaar niet overlappen.
Voorbeeld
Rittijd. Bij de leden is , , , marge , dus het interval is 12,08 ± 0,65: van 11,43 tot 12,73. Bezoekers: 10,39 ± 0,58, van 9,81 tot 10,97. De intervallen overlappen niet , dus de data laten zien dat leden langer rijden.
membervisitor91011121314Trip time (minutes)
Regel

De empirische cyclus en een conclusie beoordelen

De empirische cyclus van een onderzoek heeft vijf stappen: vraag, plan, verzamelen, analyseren en concluderen. Controleer daarna: kunnen de data vertekend zijn, zijn er uitschieters of onmogelijke waarden en gaat de conclusie verder dan de data? Beoordeel een bewering met haar onderbouwing: een verband is geen oorzaak; overlappende intervallen laten geen verschil zien; weinig rijen geven een grote marge; onmogelijke waarden trekken het gemiddelde mee; vrijwilligers zijn geen aselecte steekproef; data van één situatie bewijzen het niet voor de hele wereld. Bij De cyclus volg je de vijf stappen met getallen; bij Conclusie beoordelen lees je 6 beweringen, elk met zijn onderbouwing.
Voorbeeld
Vraag: rijden leden langer dan bezoekers? Plan: vergelijk de gemiddelden van de rittijd. Verzamelen: 1 000 ritten; 12 van 0 minuten worden weggelaten, blijven over. Analyseren: de gemiddelden zijn 12,08 en 10,39 met marges ±0,65 en ±0,58. Concluderen: de intervallen overlappen niet, dus leden rijden gemiddeld langer. Controleren: de data komen uit één verzonnen situatie, dus dit zegt niets over andere steden.
Tip

Toetsen en privacy

Elke stepper, knop en elk blok werkt met het toetsenbord: Tab gaat naar de volgende, Enter (of de spatiebalk) drukt erop en met de pijltjes omhoog en omlaag verander je een getal in een vakje. Niets wat je in deze applicaties doet wordt opgeslagen of ergens naartoe gestuurd. De datasets worden door de applicaties zelf gemaakt uit een startgetal (hetzelfde startgetal geeft dezelfde data); de situaties en de getallen zijn origineel: we hebben ze voor deze applicaties verzonnen.
Voorbeeld
Druk bij Sorteren en filteren op Tab om bij een keuze te komen, kies hem met Enter en zie de eerste rijen veranderen; de aantallen en de samenvatting onder het blad volgen.

Oefenen

In de kruistabel van een webshop heeft de rij West 84 nieuwe en 64 terugkerende klanten. Hoeveel procent van de bestellingen uit West komt van nieuwe klanten? Rond af op één decimaal. Makkelijk
Toon de oplossing
Het totaal van de rij West is .
Deel de nieuwe klanten door het totaal van de rij en vermenigvuldig met 100 → .
Van de bestellingen uit West komt 56,8% van nieuwe klanten.
Een percentage van een rij deelt door het totaal van die rij (148), niet door alle 1 000 rijen.
Het histogram toont de levertijd in klassen van 1 dag. Hoeveel rijen hebben een levertijd van 4 tot 6 dagen (de klassen 4 tot 5 en 5 tot 6)? Makkelijk
12226025819597331573212468101214Delivery time (days)
Toon de oplossing
Een staaf is een aantal rijen. Lees de twee staven af: de klasse 4 tot 5 heeft 258 rijen en de klasse 5 tot 6 heeft 195 rijen.
Tel ze op → .
453 rijen.
Een waarde van precies 6 valt in de klasse 6 tot 7 (een waarde op een grens valt in de klasse rechts ervan), dus die telt hier niet mee.
Acht steekproeven van 40 huishoudens, getrokken uit vrijwilligers, hebben gemiddelden tussen 222,6 en 262,0 kWh per maand. Het werkelijke gemiddelde van alle huishoudens is 208,2 kWh. Is dit een aselecte steekproef? Makkelijk
200225250275300Electricity (kWh a month)
Toon de oplossing
Vergelijk de steekproefgemiddelden met het werkelijke gemiddelde 208,2: het kleinste steekproefgemiddelde 222,6 ligt er al boven.
Dus alle 8 gemiddelden liggen aan één kant van het werkelijke gemiddelde.
Nee: de gemiddelden liggen allemaal boven het werkelijke gemiddelde, dus de manier van rijen kiezen is vertekend.
Een grotere steekproef van vrijwilligers herstelt dit niet: de stippen komen dan alleen dichter bij elkaar aan de verkeerde kant te liggen.
Een groepsoverzicht van de rittijd geeft: leden 572 ritten met gemiddelde 12,08 minuten, bezoekers 416 ritten met gemiddelde 10,39 minuten. Wat is het gemiddelde van alle 988 ritten? Geef twee decimalen. Middel
Toon de oplossing
Vermenigvuldig elk groepsgemiddelde met het aantal rijen van de groep → en .
Tel ze op → . Deel door het aantal rijen → .
Ongeveer 11,37 minuten.
Neem niet het gemiddelde van de twee groepsgemiddelden → is fout, want de groepen zijn niet even groot.
Bij de bezoekers is Q₁ = 6 en Q₃ = 13 minuten. Is een rit van 25 minuten een uitschieter? Gebruik de regel met 1,5 × IQR. Middel
visitor0510152025303540Trip time (minutes)
Toon de oplossing
De interkwartielafstand is .
De bovengrens is .
, dus de rit ligt boven de bovengrens.
Ja: 25 minuten ligt boven de bovengrens 23,5, dus het is een uitschieter.
De bovengrens is voor elke groep anders: bij de leden is hij 27 en zou 25 minuten daar geen uitschieter zijn.
Een aselecte steekproef van 40 huishoudens heeft gemiddelde 209,2 kWh en standaardafwijking s = 73,89. Bereken de marge (gebruik ) en het interval. Bevat het interval het werkelijke gemiddelde 208,24? Middel
Toon de oplossing
De marge is .
Het interval loopt van tot .
Het werkelijke gemiddelde 208,24 ligt tussen 185,8 en 232,6.
De marge is ongeveer 23,4 kWh en het interval van 185,8 tot 232,6 bevat het werkelijke gemiddelde.
Bij ongeveer 95 van de 100 aselecte steekproeven bevat het interval het werkelijke gemiddelde; in de applicatie kun je de rode intervallen tellen die het missen.
In de bestellingen van een webshop is de gemiddelde levertijd over alle 1 000 rijen 4,786 dagen. 7 rijen hebben de onmogelijke waarde 99. Wat is het gemiddelde zonder die rijen? Geef twee decimalen. Moeilijk
Toon de oplossing
Het totaal van alle rijen is .
De onmogelijke rijen dragen bij, dus de andere rijen hebben .
Het aantal overgebleven rijen is , dus het gemiddelde is .
Ongeveer 4,12 dagen.
De mediaan blijft 4 dagen, met of zonder deze rijen: de mediaan merkt een paar extreme waarden nauwelijks op, het gemiddelde wel.
Voor 40 ritten is de lijn van het accugebruik tegen de afstand .86x + 0,94 en r = 0,90. (a) Wat geeft de lijn voor 5 km? (b) Welke uitspraak is terecht: “langere ritten horen bij een hoger accugebruik” of “de data bewijzen dat afstand accugebruik veroorzaakt”? Moeilijk
Toon de oplossing
(a) Vul in de lijn in → .
(b) r = 0,90 is een sterk verband, stijgend: de eerste uitspraak beschrijft alleen de data, de tweede gaat verder.
(a) Ongeveer 15,24 procent van de accu. (b) Alleen de eerste uitspraak is terecht.
Een sterk verband zegt wat samengaat; voor een oorzaak is meer nodig dan één dataset.
Een steekproef heeft standaardafwijking s = 5,9. De marge mag hoogstens 0,3 zijn. Hoeveel rijen heb je minstens nodig? Moeilijk
Toon de oplossing
Draai de formule om. geeft , dus .
Vul in. , en . Dus .
Rond naar boven af, want n is een geheel getal en de marge mag niet groter zijn → .
Minstens 1 548 rijen.
Om de marge half zo groot te maken heb je vier keer zoveel rijen nodig, want n staat onder een wortel.
Bent u docent?

Geef live lessen met deze applicaties aan uw hele klas. Probeer het gratis: de eerste één maand.

Gratis proberen

Past bij deze leerjaren

IB (MYP, Diploma): Diploma, jaar 1, Diploma, jaar 2, MYP 5

Cambridge International: AS Level, A Level

Nederland: Havo · Wiskunde A, Vwo · Wiskunde A, Vwo · Wiskunde C

Turkije (MEB): Klas 12

Engeland (GCSE, A Level): Year 12 (A Level), Year 13 (A Level)

VS (Common Core): Algebra 2, Precalculus

Wat de applicaties bij dit onderwerp leren 3 applicaties

Een grote dataset sorteren, filteren en samenvatten

  • Een grote dataset sorteren op een kolom en de rijen filteren
  • Onmogelijke waarden vinden en wat ze met een gemiddelde doen
  • Een groepssamenvatting en een kruistabel lezen

Grote datasets in beeld: histogram, boxplots en spreidingsdiagram

  • Een histogram van een grote kolom lezen en de vorm benoemen
  • Boxplots lezen en uitschieters vinden met de 1,5 × IQR-regel
  • Een puntenwolk lezen met r en de lijn

De empirische cyclus met grote datasets

  • De vijf stappen van de empirische cyclus volgen
  • Een aselecte steekproef van een vertekende onderscheiden
  • Een conclusie beoordelen aan de hand van het bewijs