De populatie is de hele groep waarover we iets willen weten: alle leerlingen van een school, alle zakken die een machine vult. Een getal dat de hele populatie beschrijft is een parameter: het populatiegemiddelde μ, de standaardafwijking σ, het aandeel p. Een parameter is één vast getal, ook als we het niet kennen.
Voorbeeld
Een schaakclub heeft 8 leden van 12;14;14;15;16;16;17;20 jaar. De populatie is die 8 leden.De parameters zijn μ=124/8=15,5 jaar en σ2=5; het aandeel van 16 jaar of ouder is p=4/8=0,5.
Definitie
Steekproef en steekproefgrootheid
Een steekproef is het deel van de populatie waar we echt naar kijken. Een getal dat uit de steekproef wordt berekend is een steekproefgrootheid: het steekproefgemiddelde xˉ, het steekproefaandeel p^, de steekproefstandaardafwijking s. Een steekproefgrootheid hangt af van welke leden gekozen zijn.
Voorbeeld
Uit de club nemen we 3 leden van 14;16;20 jaar.Dan is xˉ=50/3≈16,67 en p^=32 (twee van de drie zijn 16 of ouder), terwijl de parameters μ=15,5 en p=0,5 zijn.
Regel
De schatting verandert van steekproef tot steekproef
Een steekproefgrootheid die een parameter moet raden geeft een schatting: xˉ schat μ, p^ schat p. Een andere steekproef geeft een andere schatting. Een schatting ligt dus in de buurt van de parameter, maar is de parameter niet: de parameter blijft, de schatting verandert.
Voorbeeld
Drie steekproeven van 3 leden: 14;16;20 en 12;14;15 en 15;16;17 geven xˉ=16,67, 13,67 en 16, terwijl μ=15,5 blijft.De drie schattingen zitten er +1,17, −1,83 en +0,5 naast.
Definitie
De steekproevenverdeling
Neem alle mogelijke steekproeven van grootte n en bereken voor elk dezelfde steekproefgrootheid. Die waarden vormen een verdeling: de steekproevenverdeling van die grootheid. Ze vertelt hoe de grootheid zich van steekproef tot steekproef gedraagt; de volgende kaarten gaan erover.
Voorbeeld
De populatie zijn de cijfers 0;1;2;3, elk even waarschijnlijk. Alle 16 steekproeven van grootte 2 (met teruglegging) geven xˉ=0;0,5;…;3 met aantallen 1;2;3;4;3;2;1 uit 16.Het gemiddelde is 1,5=μ en de variantie is 0,625, de helft van de populatievariantie 1,25.
Regel
Een aselecte steekproef
Bij een aselecte steekproef heeft elk lid van de populatie dezelfde kans, en elke mogelijke steekproef ook. In de methode zit niets wat naar één kant helt: over veel steekproeven liggen de steekproefgemiddelden rond μ. Een steekproef die gekozen wordt op wie makkelijk te bereiken is, of wie wil antwoorden, heeft die garantie niet.
Voorbeeld
We kiezen 3 van de 8 clubleden door namen te trekken. Er zijn (38)=56 mogelijke steekproeven, elk met kans 1/56, en elk lid zit met kans 3/8=0,375 in de steekproef.
Regel
Vier manieren om een steekproef te kiezen
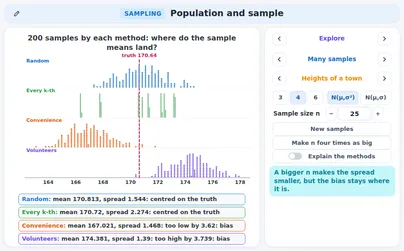
Aselect: bij toeval getrokken. Elke k-de naam van een lijst: eerlijk zolang de lijst geen herhalend patroon heeft. Gemak: wie makkelijk te bereiken is. Vrijwilligers: wie zelf kiest te antwoorden. De laatste twee zijn vertekend: hun steekproefgemiddelden liggen rond het gemiddelde van het deel van de populatie dat de methode kan bereiken.
Voorbeeld
Steekproeven van 2 uit de club.Alle 28 paren (aselect): de steekproefgemiddelden zijn gemiddeld 15,5=μ. Alleen de 5 dichtstbijzijnde leden 12;14;14;15;16 (gemak): gemiddeld 14,2, dat is −1,3 van μ. Alleen de 5 vrijwilligers 15;16;16;17;20: gemiddeld 16,8, dat is +1,3.
Let op!
Vertekening en spreiding zijn twee verschillende dingen
Een grotere steekproef brengt de steekproefgemiddelden dichter bij elkaar (minder spreiding), maar verplaatst hun midden niet. Een grote vertekende steekproef blijft vertekend: ze is alleen nauwkeurig fout. Vertekening gaat over het midden, spreiding over hoe ver de schattingen uiteenlopen.
Voorbeeld
De 5 dichtstbijzijnde leden 12;14;14;15;16 (gemak), steekproeven van 2 en van 4 zonder teruglegging.Beide hebben het midden 14,2, dat is −1,3 van μ=15,5. Maar de standaardafwijking van xˉ daalt van 0,812 (n=2) naar 0,332 (n=4).
Tip
Is de methode slecht? Drie vragen
Stel bij een steekproefmethode drie vragen. Wie kan gekozen worden? Valt er iemand af? Heeft iedereen dezelfde kans?Wie antwoordt? Verschillen degenen die antwoorden van de rest? Is een antwoord nee, zeg dan naar welke kant de uitkomst opschuift, en bedenk dat een grotere steekproef dat niet herstelt.
Voorbeeld
Een winkel vraagt de eerste 100 klanten op zaterdagochtend of de openingstijden goed zijn.Wie kan gekozen worden: alleen klanten van de zaterdagochtend; avond- en doordeweekse klanten vallen af. De uitkomst schuift op naar mensen die van de ochtend houden, en 1000 van hen vragen zou dat niet herstellen.
Regel
Van steekproef naar een informele conclusie
We gebruiken een schatting om iets over de parameter te zeggen, maar alleen informeel: "het aandeel ligt waarschijnlijk rond 0,28". De steekproevenverdeling laat zien hoe ver een schatting ernaast kan zitten. Een steekproef geeft niet de exacte waarde, en een andere aselecte steekproef geeft een andere uitspraak: dat is de grens van steekproeven.
Voorbeeld
In een steekproef van 50 leerlingen zegt 14 ja: p^=14/50=0,28.Als het echte aandeel 0,3 was, dan heeft een deel 0,957 van alle zulke steekproeven p^ tussen 0,17 en 0,43 (aantallen 9 tot 21, exact binomiaal). Dus 0,28 is een gewone uitkomst bij p=0,3, maar één steekproef kan niet bewijzen dat p precies 0,3 is.
Definitie
Het steekproefgemiddelde is een toevalsvariabele
Voordat de steekproef getrokken wordt, is het steekproefgemiddelde Xˉ=nX1+X2+⋯+Xn een toevalsvariabele: voor verschillende steekproeven neemt het verschillende waarden aan. Na het trekken hebben we één waarde xˉ. De hoofdletter Xˉ is de variabele, de kleine xˉ één waargenomen waarde.
Voorbeeld
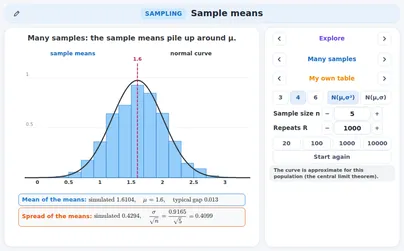
Een populatietabel: x=0;1;2;3 met kansen 0,1;0,4;0,3;0,2. Dan is μ=1,6 en σ2=0,84.Een steekproef van 2 is (1;3): xˉ=2. Een andere is (0;2): xˉ=1. Andere steekproeven, andere waarden van Xˉ.
Regel
De verwachtingswaarde van het steekproefgemiddelde
De verwachtingswaarde van het steekproefgemiddelde is het populatiegemiddelde: E(Xˉ)=μ voor elke n. Over alle steekproeven liggen de gemiddelden rond μ in evenwicht, dus xˉ is een zuivere schatting van μ. Eén steekproefgemiddelde hoeft niet gelijk te zijn aan μ.
Voorbeeld
De tabel hierboven met n=2: Xˉ neemt de waarden 0;0,5;1;1,5;2;2,5;3 aan met kansen 0,01;0,08;0,22;0,28;0,25;0,12;0,04.Dan is E(Xˉ)=∑xˉ⋅P(Xˉ=xˉ)=1,6=μ.
Regel
De variantie en de standaardfout
De waarden in een aselecte steekproef zijn onafhankelijk, dus hun varianties tellen op: Var(X1+⋯+Xn)=nσ2. Het delen van de som door n deelt de variantie door n2: Var(Xˉ)=nσ2. De standaardafwijking van Xˉ is nσ; die heet de standaardfout.
Voorbeeld
Toetsscores hebben σ=15. Het gemiddelde van n=9 scores heeft Var(Xˉ)=225/9=25, dus de standaardfout is 15/9=5.Voor de tabel hierboven en n=2: 0,84/2=0,42, en dat geeft ook de exacte tabel van Xˉ.
Regel
Meer waarden, een smaller gemiddelde
De standaardfout σ/n wordt kleiner als n groeit, maar alleen als 1/n: vier keer zoveel waarden halveert hem. Het is de spreiding van Xˉ die daalt; de spreiding σ van de populatie blijft zoals ze is.
Voorbeeld
Met σ=15 en n=1;4;16 is de standaardfout 15, 7,5 en 3,75: elke kromme is twee keer zo smal als de vorige.Het gemiddelde van 16 waarden spreidt vier keer minder dan één waarde.
Regel
De exacte tabel van het steekproefgemiddelde
Bij een kleine populatietabel kan de hele verdeling van Xˉ worden opgeschreven: noteer elke steekproef, bereken haar xˉ en tel de kansen van gelijke waarden op. Dan is elke kans over Xˉ een som van tabelwaarden, zonder benadering.
Een normale populatie geeft een normaal steekproefgemiddelde
Is de populatie normaal, X∼N(μ;σ2), dan is Xˉ∼N(μ;σ2/n) exact, voor elke n: een som van onafhankelijke normale variabelen is normaal. Dus P(Xˉ<c) is een normale kans met standaardafwijking σ/n.
Voorbeeld
Toetsscores X∼N(100;152). Eén score: P(X>110)=P(Z>10/15)≈0,2525.Het gemiddelde van n=9 scores: Xˉ∼N(100;52) en P(Xˉ>110)=P(Z>2)≈0,0228. Een gemiddelde van 9 is veel minder waarschijnlijk zo hoog.
Regel
Een kans over het steekproefgemiddelde
Om P(Xˉ<c) te vinden: (1) noem het model, Xˉ∼N(μ;σ2/n); (2) standaardiseer met de standaardfout, z=σ/nc−μ; (3) lees Φ(z) af in de tabel, of typ de rekenmachineregel met σ/n op de plaats van de standaardafwijking.
Voorbeeld
Reactietijden zijn N(250;402) ms en n=16: σ/n=40/4=10.P(Xˉ<235): z=(235−250)/10=−1,5, dus de kans is Φ(−1,5)≈0,0668. Rekenmachine: \texttt{normalcdf(-1E99; 235; 250; 10)}. Eén reactie onder 235 heeft ≈0,3538.
Let op!
σ of σ / √n?
Een veelgemaakte fout: een steekproefgemiddelde standaardiseren met σ in plaats van σ/n. Vraag je af: gaat de vraag over één waarde of over een gemiddelde van n waarden? Eén waarde: σ. Een gemiddelde van n waarden: σ/n.
Voorbeeld
Lengtes N(170;82), het gemiddelde van n=4 leerlingen, P(Xˉ>174).Goed: z=4/(8/2)=1, kans ≈0,1587. Fout: z=4/8=0,5 geeft 0,3085, dat is de kans dat één leerling langer is dan 174 cm.
Regel
De voorwaarden
Controleer voor het normale model van Xˉ drie voorwaarden. Aselect: de steekproef is aselect. 10%: bij trekken zonder teruglegging is n hoogstens 10% van de populatiegrootte N, zodat de trekkingen bijna onafhankelijk zijn. Normaal: de populatie is normaal, of n is groot (centrale limietstelling); een kleine n met sterke scheefheid of uitschieters voldoet niet.
Voorbeeld
Een school heeft N=300 leerlingen.Een aselecte steekproef van n=25 voldoet aan de 10%-voorwaarde (300/10=30≥25). Een steekproef van n=40 niet (40>30): de trekkingen zijn niet meer bijna onafhankelijk.
Definitie
Het steekproefaandeel
Het steekproefaandeel is p^=nX, waarbij X het aantal in de steekproef met de eigenschap is. Bij een aselecte steekproef die klein is ten opzichte van de populatie is X∼B(n,p) met p het aandeel in de populatie. Dus p^ is een toevalsvariabele en een zuivere schatter van p: E(p^)=p.
Voorbeeld
Een peiling onder n=50 leerlingen: 14 zeggen ja, dus p^=14/50=0,28.Een andere steekproef van 50 geeft misschien 17 keer ja: p^=17/50=0,34. Het aandeel p op school blijft hetzelfde; alleen de steekproef verandert.
Regel
Het gemiddelde en de standaardafwijking van p̂
E(p^)=p en Var(p^)=np(1−p), dus SD(p^)=np(1−p). Dit volgt uit p^=X/n met E(X)=np en Var(X)=np(1−p). Net als bij het gemiddelde halveert vier keer zoveel mensen de standaardafwijking.
Voorbeeld
p=0,3 en n=50: Var(p^)=0,3⋅0,7/50=0,0042 en SD(p^)=0,0042≈0,0648.Bij n=200 (vier keer zoveel) is het ≈0,0324, de helft.
Regel
De exacte verdeling van p̂
De exacte verdeling van p^ is de binomiale verdeling met de aantallen gedeeld door n: P(p^=k/n)=P(X=k). Een gebeurtenis over p^ is een gebeurtenis over het aantal: p^≤0,2 betekent X≤0,2n. Een benadering is niet nodig.
Voorbeeld
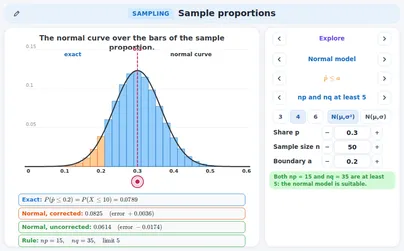
p=0,3 en n=50: p^≤0,2 is X≤10, dus P(p^≤0,2)=P(X≤10)≈0,0789.Rekenmachine: \texttt{binomcdf(50; 0,3; 10)}.
Regel
Het normale model en de continuïteitscorrectie
Voor grote n volgen de staven van p^ de normale kromme N(p;p(1−p)/n). De staven zijn discreet: behandel p^≤a als het aantal X≤k en gebruik de continuïteitscorrectie met grens k+21. De gecorrigeerde waarde ligt meestal veel dichter bij de exacte dan de ongecorrigeerde.
Voorbeeld
Hetzelfde voorbeeld: X≈N(15;10,5).Gecorrigeerd: z=(10,5−15)/10,5≈−1,39, dus Φ(−1,39)≈0,0825. Ongecorrigeerd: z=(10−15)/10,5≈−1,54, dus 0,0614. De exacte waarde is 0,0789: fouten 0,0036 en 0,0174.
Regel
De voorwaarden voor p̂
Het normale model voor p^ vraagt een aselecte steekproef, n hoogstens 10% van de populatie, en genoeg successen en mislukkingen: np en nq=n(1−p) allebei minstens 10 (de AP-regel) of minstens 5 (de Cambridge-regel). Anders zijn de staven scheef en volgt een normale kromme ze niet.
Voorbeeld
n=50, p=0,3: np=15 en nq=35, allebei minstens 10: goed.n=20, p=0,1: np=2 is te klein. De staaf p^=0 heeft 0,920≈0,1216 en staat tegen de rand, en de kromme negeert dat p^ niet negatief kan zijn.
Regel
Zeg het als een zin over steekproeven
Zeg een kans over p^ (of Xˉ) als een zin over steekproeven: "In aselecte steekproeven van grootte n uit een populatie waarin …, is de kans dat … ongeveer …". De kans hoort bij de steekproefgrootheid. De parameter staat in de voorwaarde van de zin, niet in de gebeurtenis.
Voorbeeld
In aselecte steekproeven van 50 uit een populatie waarin 30% het plan steunt, is de kans dat hoogstens 20% van de steekproef het plan steunt ongeveer 0,0789.
Let op!
Een kans over de steekproef, niet over p
Een veelgemaakte fout: de 0,0789 lezen als een uitspraak over de parameter, alsof p degene is die varieert. Het aandeel p in de populatie is één vast getal; het zijn de steekproeven die variëren. De zin gaat over het steekproefaandeel p^ in de steekproeven uit deze populatie. Hetzelfde geldt voor een gemiddelde: een uitspraak over Xˉ hoort bij de steekproeven, niet bij μ.
Voorbeeld
Beter: "Als het aandeel 30% is, heeft ongeveer 7,9% van de steekproeven van 50 hoogstens 20% voorstanders." Hier is 30% gegeven en de 7,9% telt steekproeven.Een peiling die 20% vindt, maakt het aandeel geen 20%; het is één steekproef uit de vele die getrokken hadden kunnen worden.
Regel
Vormen worden klokken
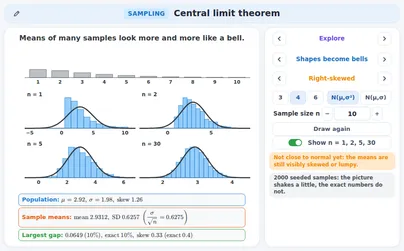
De centrale limietstelling: welke vorm een populatie ook heeft (met een gemiddelde en een standaardafwijking), de verdeling van Xˉ komt dichter bij de normale kromme N(μ;σ2/n) naarmate n groeit. De staven van Xˉ worden een klok die het midden μ houdt en smaller wordt.
Voorbeeld
Een rechtsscheve populatie (de waarden 1 tot en met 10, gemiddelde 2,925, σ≈1,984). De tekeningen tonen de exacte verdeling van Xˉ voor n=1;2;5;30 met de normale kromme: scheef bij n=1, een klok bij n=30.De scheefheid van Xˉ is die van één waarde gedeeld door n: 1,26, 0,89, 0,56 en 0,23.
Regel
Hoe groot is groot?
Hoe groot n moet zijn hangt van de populatie af. De regels: Cambridge zegt "een grote steekproef" zonder getal, IB zegt dat n>30 bij examens voldoende is, AP gebruikt n≥30. Het zijn vuistregels. De applicatie meet ook het grootste verschil tussen een staaf van Xˉ en de kromme als aandeel van de top, en de scheefheid van Xˉ; ze noemt het dicht bij normaal als het verschil onder 8% en de scheefheid onder 0,2 ligt.
Voorbeeld
Rechtsscheve populatie, verschil (aandeel van de top) en scheefheid van Xˉ:n=5: 14,9% en 0,56; n=10: 10,1% en 0,40; n=30: 5,3% en 0,23; n=100: 3,0% en 0,13.Bij n=30 is het verschil klein maar de scheefheid 0,23 nog boven 0,2; bij n=100 zijn beide klein. Een populatie die op een normale lijkt is vanaf n=1 dicht bij normaal (verschil 4,4%).
Let op!
Een zeer scheve populatie
Let op (AP): als de populatie extreem scheef is, of één enorme waarde bevat, kan n=30 te weinig zijn. Kijk naar de tekening van Xˉ, niet alleen naar het getal n.
Voorbeeld
Een populatie waarin 99% van de waarden 1 is en 1% de waarde 10 heeft (gemiddelde 1,09).Een steekproef van 30 bevat geen 10 met kans 0,9930≈0,7397, dus bij ongeveer 74% van de steekproeven is xˉ=1 precies; bij de rest springt het in stappen. De scheefheid van Xˉ is nog steeds 1,80 bij n=30 en 0,98 bij n=100 (verschil 15% en 31% van de top).
Regel
Sommen en gemiddelden
De som S=X1+⋯+Xn en het gemiddelde Xˉ=S/n zijn dezelfde trekkingen op twee schalen. Is Xˉ dicht bij normaal, dan is S dat ook: S≈N(nμ;nσ2) en Xˉ≈N(μ;σ2/n). De som heeft gemiddelde nμ en standaardafwijking σn.
Voorbeeld
De rechtsscheve populatie, n=30: S heeft gemiddelde 30μ=87,74 en variantie 30σ2=118,13, dus standaardafwijking 10,869.P(S≥100): exact 0,1410; normaal met continuïteitscorrectie (grens 99,5, z=1,08) 0,1395; zonder (z=1,13) 0,1296. De gebeurtenis Xˉ≥100/30 is dezelfde gebeurtenis.
Let op!
De stelling gaat over het steekproefgemiddelde
Een veelgemaakte fout: "bij een grote steekproef worden de gegevens normaal". Het histogram van één grote steekproef houdt de vorm van de populatie. De stelling gaat over de verdeling van Xˉ over veel steekproeven. Een grotere steekproef verandert de populatie niet; alleen de verdeling van Xˉ wordt smaller en ronder.
Voorbeeld
De rechtsscheve populatie heeft scheefheid 1,26, dus een histogram van 30 waarden daaruit is ook scheef.De gemiddelden van veel steekproeven van 30 hebben scheefheid 1,26/30≈0,23: zij zijn het die op een klok lijken.
Definitie
Schatter en zuiver
Een schatter is een regel die van een steekproef een schatting van een parameter maakt (xˉ voor μ). Hij is zuiver als zijn verwachtingswaarde de parameter is: over alle steekproeven gemiddeld raken de schattingen de parameter. Een vertekende schatter zit gemiddeld ernaast, steeds aan dezelfde kant.
Voorbeeld
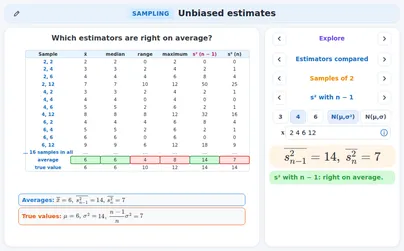
De populatie is 2;4;6;12: μ=24/4=6 en σ2=56/4=14.We nemen alle 16 steekproeven van grootte 2 (met teruglegging) en middelen een schatter daarover. Hij is zuiver als dat gemiddelde gelijk is aan μ (of σ2), wat de losse steekproeven ook doen.
Regel
Het steekproefgemiddelde is zuiver
Het steekproefgemiddelde is een zuivere schatting van μ: E(Xˉ)=μ. Je kunt het controleren door alle steekproeven van een kleine populatie op te sommen: het gemiddelde van alle steekproefgemiddelden is precies μ.
Voorbeeld
Alle 16 steekproeven van grootte 2 uit 2;4;6;12 (tekening: het vakje is xˉ van de rijwaarde en de kolomwaarde). De 16 gemiddelden tellen op tot 96, dus hun gemiddelde is 96/16=6=μ.Losse gemiddelden lopen van 2 tot 12, het gemiddelde is precies goed.
Regel
De steekproefvariantie met deler n − 1
De steekproefvariantie s2=n−1∑(x−xˉ)2 (deler n−1) is een zuivere schatting van σ2. Met deler n is ze gemiddeld te laag: E(n1∑(x−xˉ)2)=nn−1σ2.
Voorbeeld
Dezelfde 16 steekproeven, σ2=14. Deler n−1=1: de vakjes lopen van 0 tot 50, tellen op tot 224 en hebben gemiddelde 224/16=14=σ2.Deler n=2 halveert elk vakje: totaal 112, gemiddelde 7=21⋅14.
Tip
Waarom n − 1?
De afwijkingen van xˉ zijn kleiner dan de afwijkingen van μ, omdat xˉ het midden van juist deze steekproef is. Precies: ∑(x−μ)2=∑(x−xˉ)2+n(xˉ−μ)2. Dus ∑(x−xˉ)2 is n(xˉ−μ)2 te klein, en dat is gemiddeld σ2. Delen door n−1 in plaats van n herstelt dat.
Voorbeeld
De steekproef 2;12 uit de populatie met μ=6: ∑(x−μ)2=16+36=52.Met xˉ=7: ∑(x−xˉ)2=25+25=50 en n(xˉ−μ)2=2⋅1=2, en 50+2=52.
Regel
x̄, s² en s berekenen
Uit gegevens: xˉ=n∑x, s2=n−1∑(x−xˉ)2 en s=s2. Uit de sommen n, ∑x en ∑x2: s2=n−11(∑x2−n(∑x)2). Houd breuken of veel decimalen vast tot het eind.
Voorbeeld
n=10, ∑x=52, ∑x2=312: xˉ=526=5,2.∑x2−(∑x)2/n=312−270,4=41,6, dus s2=41,6/9=45208≈4,6222 en s≈2,1499. Met deler n: 41,6/10=4,16.
Tip
Sx en σx op de rekenmachine
Een rekenmachine geeft twee standaardafwijkingen. Sx heeft deler n−1: de schatting van σ uit een steekproef. σx heeft deler n: voor een lijst die de hele populatie is. Gebruik voor een steekproef Sx. Sommige merken en boeken schrijven sn−1 en sn, of s en σ.
Voorbeeld
Gegevens 4;7;7;8;9: xˉ=7 en ∑(x−xˉ)2=9+0+0+1+4=14.Sx=14/4=3,5≈1,8708 en σx=14/5=2,8≈1,6733.
Let op!
Het maximum en het bereik zijn vertekend
Niet elke natuurlijke steekproefgrootheid is zuiver. Het steekproefmaximum is te laag als schatting van het populatiemaximum, en het steekproefbereik te laag als schatting van het populatiebereik, omdat een steekproef de uitersten meestal mist. Hun gemiddelde over alle steekproeven ligt onder het doel.
Voorbeeld
2;4;6;12 en de 16 steekproeven van grootte 2: het maximum is gemiddeld 128/16=8 maar het populatiemaximum is 12; het bereik is gemiddeld 64/16=4 maar het populatiebereik is 12−2=10.
Let op!
Zuiver gaat over de lange termijn
Zuiver betekent niet dat één schatting goed is: het betekent dat de schattingen over veel steekproeven gemiddeld goed zijn. Een zuivere schatter kan in één steekproef nog ver ernaast zitten. Ook is s een licht vertekende schatting van σ, hoewel s2 zuiver is voor σ2.
Voorbeeld
Een vaste run (tekening): populatie N(0;22), steekproeven van 5. De lopende gemiddelden van s2 komen bij hun doelen: met deler n−1 bij 4 (groen) en met deler n bij 54⋅4=3,2 (blauw).Voor 2;4;6;12 is het gemiddelde van s over de 16 steekproeven 2,828, onder σ≈3,742.
Regel
Zuiver en een kleine spreiding
Twee zuivere schatters kunnen verschillen in spreiding. Die met de kleinere variantie is beter, omdat haar losse schattingen dichter bij het doel liggen. Een goede schatter is zuiver (het midden klopt) en heeft een kleine variantie (weinig spreiding).
Voorbeeld
Om μ=6 te schatten uit 2 trekkingen: de eerste trekking alleen is zuiver met variantie 14; xˉ is zuiver met variantie 14/2=7.In de tekening liggen de 16 eerste trekkingen (blauw) verspreid over 2 tot 12, de 16 gemiddelden (groen) minder.
Regel
De grootte van een peiling
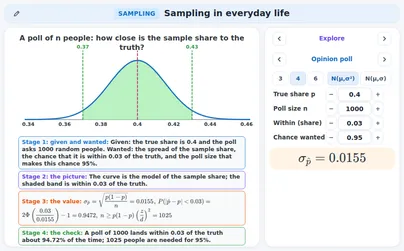
Bij een peiling onder n mensen heeft het steekproefaandeel standaardafwijking p(1−p)/n, het grootst bij p=0,5. Ongeveer 95% van de peilingen valt binnen 1,96 standaardafwijkingen van p. De marge wordt kleiner als 1/n, dus een halve marge vraagt vier keer zoveel mensen.
Voorbeeld
Bij p=0,5 en n=100;400;1600 is de standaardafwijking 0,05, 0,025 en 0,0125.Voor een marge van 0,03: n≥1,962⋅0,25/0,032≈1067,1, dus n=1068. (De exacte binomiale verdeling geeft 0,953 voor binnen 0,03 liggen.)
Regel
Zakken bloem
Een machine vult zakken met gemiddeld gewicht μ en standaardafwijking σ. Eén zak varieert met σ; het gemiddelde van n zakken varieert met σ/n. Een vraag over één zak onder het etiket gebruikt dus σ en een vraag over het gemiddelde van n zakken gebruikt σ/n.
Voorbeeld
μ=1012 g, σ=15 g, etiket 1000 g, normaal verdeelde gewichten. Eén zak zit met kans Φ(−0,8)≈0,2119 onder het etiket.Het gemiddelde van n=9 zakken: σ/9=5, z=−2,4, P(Xˉ<1000)≈0,0082.
Regel
Reistijden
Reistijden zijn meestal rechtsscheef: een paar heel lange. Het gemiddelde van n reizen is dan maar bij benadering normaal, en beter naarmate n groter is. Vergelijk voor een veilige uitspraak met de exacte verdeling, of kijk naar de scheefheid van Xˉ.
Voorbeeld
Tijden 10;14;…;46 minuten met de rechtsscheve vorm: gemiddelde 17,7 min, standaardafwijking 7,9 min, scheefheid 1,26.n=10: P(Xˉ>22) is exact 0,0467, het normale model zegt 0,0433 (scheefheid van Xˉ0,40). n=30: exact 0,0027, normaal 0,0015: het normale model onderschat de bovenste staart.
Regel
Labmetingen
Herhaal een meting n keer: de metingen hebben een spreiding s en het gemiddelde van de metingen heeft de standaardfouts/n. Het gemiddelde is betrouwbaarder dan één meting, en vier keer zoveel metingen halveert de standaardfout.
Voorbeeld
Metingen 12,1;11,8;12,4;12,0;12,2;11,9: xˉ=72,4/6≈12,067, s≈0,2160, standaardfout s/6≈0,0882.Bij 24 metingen met dezelfde spreiding is de standaardfout 0,0441, de helft.
Tip
Welke opleiding vraagt wat
Cambridge 9709 (Paper 6): steekproef en populatie, het steekproefgemiddelde als toevalsvariabele, de centrale limietstelling, zuivere schattingen van gemiddelde en variantie. UK GCSE en A level: uit een steekproef iets afleiden, populatie en steekproef, steekproeftechnieken. IB (AA en AI): steekproeven en vertekening; AI HL: zuivere schattingen en de centrale limietstelling. AP Statistics: steekproevenverdelingen van p^ en xˉ, voorwaarden, zuivere schatters. Common Core: statistiek als afleiden uit een aselecte steekproef. Nederland: wiskunde A vwo, een uitspraak over een populatie op grond van een steekproef.
Voorbeeld
Een typische examenvraag: een populatie heeft gemiddelde 50 en standaardafwijking 8; een aselecte steekproef van n=64.De standaardfout is 8/64=1, en P(Xˉ>51,5): z=1,5, dus 1−0,9332=0,0668 (de centrale limietstelling, omdat n groot is).
Oefenen
Een school heeft 800 leerlingen; aan 40 van hen wordt gevraagd hoe ze reizen en 22 fietsen er. Noem de populatie en de steekproef. Is 22/40 een parameter of een steekproefgrootheid? Makkelijk
Toon de oplossing
De populatie is alle 800 leerlingen; de steekproef zijn de 40 die gevraagd zijn.
22/40 wordt uit de steekproef berekend, dus het is een steekproefgrootheid: p^=22/40=0,55.
Het aandeel van alle 800 dat fietst is de parameter p; p^ schat die.
Populatie: de 800 leerlingen; steekproef: de 40; p^=0,55 is een steekproefgrootheid
Controle → een andere steekproef van 40 geeft waarschijnlijk een andere p^; p blijft.
Een aselecte steekproef van 5 leerlingen heeft lengtes 63;71;66;68;62 cm. De gemiddelde lengte van alle leerlingen is μ=65 cm. Bereken xˉ en het verschil xˉ−μ. Makkelijk
Toon de oplossing
Tel de lengtes op: 63+71+66+68+62=330.
Deel door n=5: xˉ=330/5=66.
Het verschil is 66−65=+1 cm: deze steekproef zit iets boven μ.
xˉ=66 cm, verschil +1 cm
Controle → het gemiddelde 66 ligt tussen de kleinste (62) en de grootste (71) waarde.
Een populatie heeft standaardafwijking σ=12. Bereken de standaardfout van het steekproefgemiddelde voor n=36, en voor een vier keer zo grote steekproef. Makkelijk
Toon de oplossing
De standaardfout is σ/n=12/36=12/6=2.
Vier keer zo groot is n=144: 12/144=12/12=1.
Vier keer zo grote steekproef halveert de standaardfout; de spreiding σ=12 van de populatie verandert niet.
2 bij n=36 en 1 bij n=144
Controle → 144=4⋅36 en 1=2/2.
In een populatie heeft 40% een eigenschap. Er wordt een aselecte steekproef van n=100 genomen. Bereken het gemiddelde en de standaardafwijking van het steekproefaandeel p^. Makkelijk
Toon de oplossing
Het gemiddelde van p^ is p=0,4.
De variantie is p(1−p)/n=0,4⋅0,6/100=0,0024.
De standaardafwijking is 0,0024≈0,0490.
Gemiddelde 0,4, standaardafwijking ≈0,0490
Controle → 0,0492≈0,0024.
Een steekproef is 3;5;10. Bereken het steekproefgemiddelde xˉ, de steekproefvariantie s2 (deler n−1) en s. Makkelijk
Toon de oplossing
xˉ=(3+5+10)/3=18/3=6.
De gekwadrateerde verschillen: (3−6)2+(5−6)2+(10−6)2=9+1+16=26.
s2=26/(3−1)=13 en s=13≈3,606.
xˉ=6, s2=13, s≈3,606
Controle → met deler n kreeg je 26/3=326≈8,667, een kleiner getal dan 13.
Een school heeft 250 leerlingen. Er wordt een aselecte steekproef zonder teruglegging genomen en de 10%-voorwaarde moet gelden. Wat is de grootste steekproefgrootte n? Makkelijk
Toon de oplossing
De 10%-voorwaarde zegt n≤10%⋅N.
Hier is N=250, dus n≤250/10=25.
De grootste steekproef heeft n=25 leerlingen.
n=25
Controle → 25 is precies een tiende van 250.
Scores zijn normaal, N(500;402). Bereken P(Xˉ>510) voor een aselecte steekproef van n=16, en vergelijk met P(X>510) voor één score. Middel
Toon de oplossing
Het model is Xˉ∼N(500;102), want 40/16=10.
z=(510−500)/10=1, dus P(Xˉ>510)=1−Φ(1)≈0,1587.
Voor één score is z=10/40=0,25 en P(X>510)≈0,4013.
P(Xˉ>510)≈0,1587 tegen P(X>510)≈0,4013
Controle → een gemiddelde van 16 scores wijkt minder snel ver van 500 af dan één score, dus 0,1587<0,4013.
Een populatie heeft standaardafwijking σ=20. Hoe groot moet een aselecte steekproef zijn om de standaardfout van het gemiddelde hoogstens 2,5 te laten zijn? Middel
Toon de oplossing
We eisen 20/n≤2,5, dus n≥20/2,5=8.
Kwadrateren: n≥82=64.
n≥64
Controle → 20/64=20/8=2,5.
In een populatie is 60% het eens; een aselecte steekproef heeft n=80. Controleer de voorwaarden en bereken P(p^<0,5) met de continuïteitscorrectie (exacte waarde 0,0271). Middel
Toon de oplossing
np=48 en nq=32, allebei minstens 10: het normale model mag.
p^<0,5 betekent X≤39, en X≈N(48;19,2).
Grens 39,5: z=(39,5−48)/19,2≈−1,94, dus P≈0,0262.
P(p^<0,5)≈0,0262 (exact 0,0271)
Controle → zonder correctie (grens 39) krijg je 0,0200, verder van 0,0271.
Een stad heeft N=400 inwoners. Er wordt een aselecte steekproef van n=60 zonder teruglegging genomen met een ja / nee-vraag; ongeveer 5% zal ja zeggen. Mag het normale model voor p^ gebruikt worden? Middel
Toon de oplossing
Aselectheid: de steekproef is aselect, dus aan deze voorwaarde is voldaan.
10%-voorwaarde: 10%⋅400=40 en 60>40: niet voldaan.
Aantallen: np=60⋅0,05=3, onder 10 (en onder 5): niet voldaan.
Nee: twee voorwaarden falen (10% en np), alleen de aselecte voorwaarde geldt
Controle → een steekproef van 40 of minder zou aan de 10%-voorwaarde voldoen, maar np blijft te klein.
Uit een steekproef: n=8, ∑x=72 en ∑x2=702. Bereken xˉ en s2 met deler n−1, en vergelijk met deler n. Middel
Toon de oplossing
xˉ=72/8=9 en 702−722/8=702−648=54.
s2=54/7=754≈7,7143; met deler n: 54/8=6,75.
xˉ=9, s2=54/7≈7,7143 (deler n: 6,75)
Controle → deler n geeft het kleinere getal: 6,75<7,7143.
Populatie 1;3;8, alle 9 steekproeven van 2 met teruglegging. Toon aan: xˉ is gemiddeld μ, s2 (deler n−1) gemiddeld σ2, deler n geeft de helft. Middel
Toon de oplossing
μ=4, σ2=26/3. De negen gemiddelden tellen op tot 36: gemiddelde 4=μ.
De negen waarden van s2 tellen op tot 78: gemiddelde 78/9=326=σ2.
Deler n=2 halveert elke waarde: gemiddelde 313.
Gemiddelden: 4=μ en 26/3=σ2; met deler n: 13/3
Controle → de helft van 26/3 is 13/3.
Reistijden (rechtsscheef): gemiddelde 17,7 min, standaardafwijking 7,9 min, n=40. Bereken P(Xˉ>20) en noem de regel die het normale model toestaat. Moeilijk
Toon de oplossing
Centrale limietstelling: n=40≥30 (de AP-regel). 7,9/40≈1,255.
z=(20−17,7)/1,255≈1,83, dus P(Xˉ>20)≈0,0333.
De exacte verdeling van deze scheve vorm geeft 0,0358: iets meer.
P(Xˉ>20)≈0,0333 (exact: 0,0358)
Controle → model en exacte waarde verschillen minder dan 0,003.
Een peiling wil een marge van 0,04, waarbij de marge 1,96 standaardafwijkingen van p^ is (ongeveer 95%). Neem het ongunstigste geval p=0,5. Hoeveel mensen zijn nodig? Hoeveel voor een marge van 0,02? Moeilijk
Toon de oplossing
1,960,25/n≤0,04, dus n≥1,962⋅0,25/0,042=600,25: naar boven afronden geeft n=601.
Een marge van 0,02 is de helft, dus vier keer zoveel: 1,962⋅0,25/0,022=2400,99, dus n=2401.
n=601 voor 0,04 en n=2401 voor 0,02
Controle → 2401 is ongeveer vier keer 601 (4⋅600,25=2401).
Zakken bloem zijn normaal verdeeld, gemiddelde 1012 g, standaardafwijking 15 g. Bereken de kans dat het gemiddelde van 9 zakken binnen 3 g van 1012 g ligt, en hetzelfde voor één zak. Moeilijk
Toon de oplossing
Gemiddelde van 9: σ/9=5, dus ∣z∣<3/5=0,6 en P=Φ(0,6)−Φ(−0,6)≈0,4515.
Eén zak: ∣z∣<3/15=0,2, dus P≈0,1585.
Ongeveer 0,4515 voor het gemiddelde van 9 en 0,1585 voor één zak
Controle → het gemiddelde blijft vaker dicht bij 1012 dan één zak: 0,4515>0,1585.
Steekproeven van 50 uit een populatie waarin 30% een plan steunt: P(p^≤0,2)≈0,0789. Welke zin klopt?A: Omdat 0,0789 klein is, ligt het aandeel onder 20%.B: Als het aandeel 30% is, heeft 7,9% van de steekproeven hoogstens 20% voorstanders.C: Deze peiling is fout met kans 7,9%.Moeilijk
Toon de oplossing
0,0789 telt steekproeven bij een gegeven aandeel, 30%. A en C maken er een uitspraak over het aandeel of over “fout” van.
Alleen B houdt het aandeel in de voorwaarde.
B
Controle → B begint met “Als het aandeel 30% is”.
X1 en X2 zijn onafhankelijk, met gemiddelde μ en variantie σ2. Laat zien dat T1=(X1+X2)/2 en T2=(X1+2X2)/3 allebei zuiver zijn voor μ en bepaal welke de kleinere variantie heeft. Moeilijk
Toon de oplossing
E(T1)=(μ+μ)/2=μ en E(T2)=(μ+2μ)/3=μ: beide zijn zuiver.
Var(T1)=(σ2+σ2)/4=21σ2.
Var(T2)=(σ2+4σ2)/9=95σ2>21σ2.
Beide zijn zuiver; T1=Xˉ heeft de kleinere variantie
Controle → 91+94=95; in de tekening is de rij van T2 breder.
Een leerling berekent de variantie van steekproeven van grootte 5 met deler n. De populatievariantie is σ2=20. Met welke factor, en tot welke waarde, klopt het gemiddelde van haar uitkomsten niet? Hoe herstelt ze het? Moeilijk
Toon de oplossing
Met deler n is het gemiddelde nn−1σ2=54⋅20=16: een factor 0,8 te laag.
Ze herstelt het door dezelfde kwadratensom te delen door n−1=4 in plaats van n=5: 16⋅45=20.
Een factor 0,8 te laag: 16 in plaats van 20; deel door n−1
Controle → 16⋅5/4=20.
Een gemakssteekproef van 10000 heeft een gemiddelde dat doorgaans 2 g te laag is. Een aselecte steekproef van 100 komt uit een populatie met σ=15 g. Vergelijk de standaardfouten en het soort fout. Moeilijk
Toon de oplossing
De standaardfout bij n=10000 is 15/100=0,15 g; bij n=100 is die 15/10=1,5 g.
De grote steekproef is nauwkeurig maar ongeveer 2 g vertekend; meer mensen verandert dat niet. De aselecte steekproef is zuiver: haar fout is alleen toeval.
De grote steekproef heeft de kleinere standaardfout (0,15 g tegen 1,5 g) maar een vertekening van ongeveer 2 g; de aselecte steekproef is zuiver
Controle → vertekening gaat over het midden en een grotere n verplaatst dat niet.
Interactieve applicaties bij dit onderwerp
Gratis applicaties openen met een gratis leerlingaccount. Docenten kunnen alle applicaties gebruiken in een live les.